Ein Gesichtsdetektor restaurierte einmal die Hose eines Kleinkinds
In der frühen Testphase meldete der Gesichtsdetektor eine selbstbewusste Erkennung auf einem Familienschnappschuss, und die Pipeline „restaurierte“ sie pflichtbewusst, nur war die Erkennung die Cordhose eines Kleinkinds. Die Stofffalten lasen sich für den Detektor wie ein Gesicht, und das Gesichtsmodell malte sie dann als eines neu. Der Fehler lehrte uns, dass auf alten Fotografien die Detektor-Konfidenz allein kein brauchbares Signal ist, und er brachte die geometrische Prüfung hervor, die jedes Kandidatengesicht jetzt bestehen muss. Diese Überarbeitung ergänzt die andere Hälfte der Geschichte, gemessen: wie klein ein Gesicht sein darf, damit der Detektor es überhaupt findet. Die Untergrenze liegt zwischen 14 und 20 Letterbox-Pixeln, und das berühmte Foto der Solvay-Konferenz von 1927, dessen 29 Gesichter 21–27 px hoch sind, besteht sie mit jedem einzelnen gefundenen Teilnehmer.
Jede Zahl in dieser Notiz wurde mit dem Code der Produktions-Pipeline gemessen: dieselben Modelle, dieselbe Mathematik. Rohdaten pro Bild: e5_detect.json.
1 · Warum alte Fotos Gesichtsdetektoren brechen
Detektoren werden überwiegend auf modernen, gut belichteten Bildern trainiert. Alte Scans zeigen Texturen, die der Trainingsdatensatz selten enthält: Gewebestrukturen, Spitze, Laub, Wasserschäden und Korn, alle in der Lage, Fehlerkennungen mit hoher Konfidenz zu erzeugen. Sie zeigen auch das gegenteilige Problem: echte Gesichter, die klein, verblasst und kontrastarm sind. Eine Konfidenzschwelle allein kann die beiden nicht trennen, weil die Fehltreffer häufig höher punkten als die echten kleinen Gesichter. Unser Detektor ist SCRFD-2.5G[1], 1:1 aus der FaceFusion-Referenzimplementierung dekodiert[2]: Das Foto wird in einen 640×640-Input geletterboxt, und jeder Kandidat kommt mit einer Box, fünf Landmarken und einem Konfidenzwert zurück.
2 · Die Prüfung
Statt dem Wert zu vertrauen, testen wir, ob die Landmarken der Erkennung wie ein Gesicht angeordnet sind: billige Arithmetik auf den Augen- und Mundpunkten:
| Regel | Schwelle | Was sie ausschließt |
|---|---|---|
| Detektor-Konfidenz | ≥ 0,55 | Grenzwertige Erkennungen, die keine weitere Prüfung wert sind. |
| Augenabstand vs. Boxbreite | 0,25 – 0,75 | Landmarken-Cluster, die zu eng oder zu weit sind, um zwei Augen in einer gesichtsgroßen Box zu sein: die typische Geometrie von Stofffalten-Fehltreffern. |
| Mund unter den Augen | um ≥ 0,2 × Augenabstand | Auf dem Kopf stehende und durcheinandergewürfelte Landmarken-Anordnungen. |
Die Schwellen sind bewusst locker: Sie beschreiben jedes plausible menschliche Gesicht, einschließlich geneigter und Dreiviertelansichten, und schließen Anordnungen aus, die kein Gesicht haben kann. Seit die Prüfung ausgeliefert ist, ist die Hosen-Klasse von Fehlern auf unseren Testfotos nicht wieder aufgetreten.
3 · Neu: die Erkennungsuntergrenze, gemessen
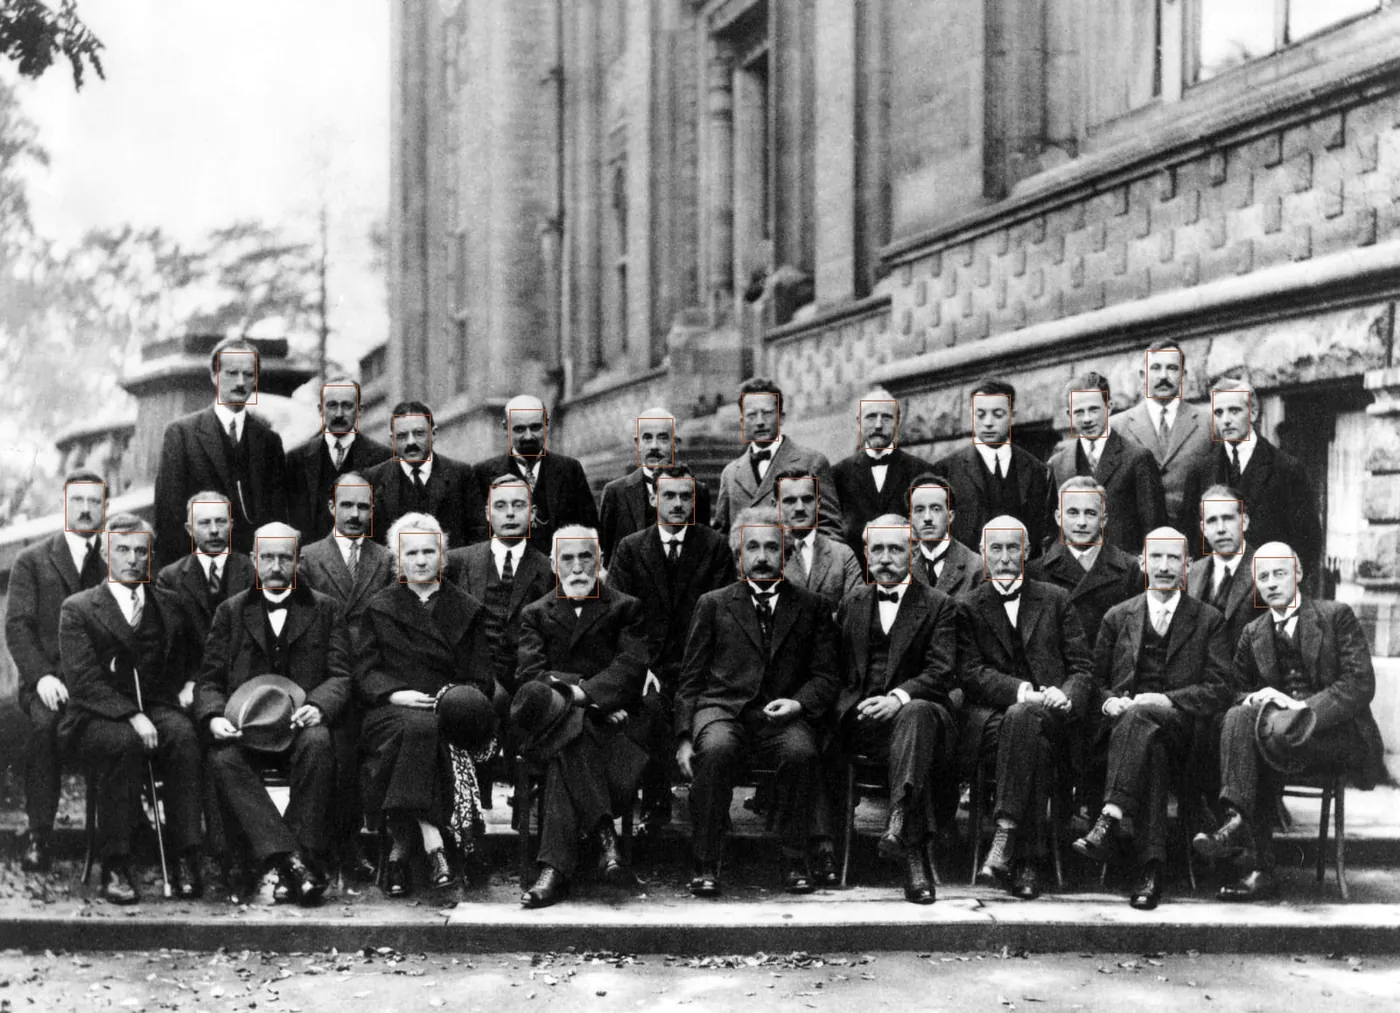
Das Solvay-Ergebnis landet genau dort, wo die Leiter es vorhersagt, auf der guten Seite: alle 29 von 29 Teilnehmern im Ganzbildmaßstab erkannt, Konfidenz 0,734–0,864, jeder einzelne übersteht die geometrische Prüfung. Und eine Kontrolle, die es wert ist, veröffentlicht zu werden, weil sie kontraintuitiv ist: Dasselbe Foto naiv 2×2 zu kacheln (mehr Pixel pro Gesicht) findet nur 27 von 29. Zwei Gesichter liegen auf Kachelgrenzen und werden von keiner Kachel ganz gesehen; ein 3×3-Raster schneidet zufällig woanders und findet alle 29 wieder. Diese Asymmetrie ist der Grund, warum der Kleingesicht-Durchgang der Browser-Engine auf dem ganzen Bild und auf überlappenden Quadranten erkennt und die Kandidaten per Intersection-over-Union zusammenführt: Gekachelte Erkennung braucht Überlappung, nicht nur Auflösung.
Die praktische Lesart für Gruppenfotos: Ein Gesicht, das kleiner ist als etwa 3 % der langen Kante des Fotos, ist für den Detektor unsichtbar. Schneide vor der Restaurierung enger zu (dieselben Pixel kommen durch den Letterbox größer zurück, auf der sicheren Seite der Klippe) und lies die Notiz zum Gesichts-Rendering dazu, was mit kleinen Gesichtern nach der Erkennung passiert.
4 · Einschränkungen
Eine geometrische Prüfung kann nur unmögliche Anordnungen ausschließen. Ein Fehltreffer, der zufällig gesichtsförmig ist (eine Puppe, eine Statue, ein Porträt an der Wand), besteht sie, und sollte es wohl auch, denn ihn zu restaurieren ist harmlos. Die Aufgabe der Prüfung ist eng: nie wieder jemandes Kleidung als Gesicht neu malen. Die Messungen zur Untergrenze umfassen ein Porträt und ein Gruppenfoto: genug, um die Klippe zwischen 14 und 20 px zu verorten, nicht, um ihre genaue Form über Posen und Beleuchtung hinweg zu kartieren; und die Konfidenz zwischen 20 und 28 px ist merklich verrauschter als darüber, sodass Gesichter in diesem Band als gefährdet und nicht als sicher gelten sollten.
Quellen
- Guo, J., Deng, J., Lattas, A., & Zafeiriou, S. (2021). Sample and Computation Redistribution for Efficient Face Detection. arXiv:2105.04714. arxiv.org
- FaceFusion (open-source face processing platform): the reference implementation our SCRFD decode and model preprocessing are ported from, 1:1. github.com
- Couprie, B. (1927). Photograph of the Fifth Solvay International Conference: 29 attendees, the densest concentration of physics Nobel laureates ever photographed. Public domain, via Wikimedia Commons. commons.wikimedia.org
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai