Warum KI-restaurierte Gesichter wie Videospielfiguren aussehen
Gesichtsrestaurierungsmodelle können ein Gesicht aus einem beschädigten Foto aussehen lassen wie ein Rendering aus einem alten Videospiel: Plastikhaut, gemalte Augen, ein Gesicht, das scharf ist, aber nicht ganz die Person. Wir haben acht Rendering-Varianten an 11 gemeinfreien Fotografien gebenchmarkt, um die Ursachen zu isolieren: Es sind drei, sie sind trennbar, und keine wird durch ein „besseres Modell“ behoben. Diese Überarbeitung ergänzt, was der ursprünglichen Testreihe fehlte: Zahlen. Die Nachmessung des gewählten Renderings mit einem Gesichtserkennungs-Embedding[4] bestätigt die Auswahl nach Augenmaß quantitativ (jeder Regler des „natürlichen“ Renderings kauft messbar Identität und halbiert die Identitätssteuer der Restaurierung), und ein vollständiger Durchlauf des Treue-Reglers zeigt, warum er bei 0,7 ausgeliefert wird, obwohl jede Kurve monoton Richtung 1,0 steigt.
Jede Zahl in dieser Notiz wurde mit dem Code der Produktions-Pipeline gemessen: dieselben Modelle, dieselbe Mathematik. Rohdaten pro Bild: e2v2_face.json · e2_face.json.
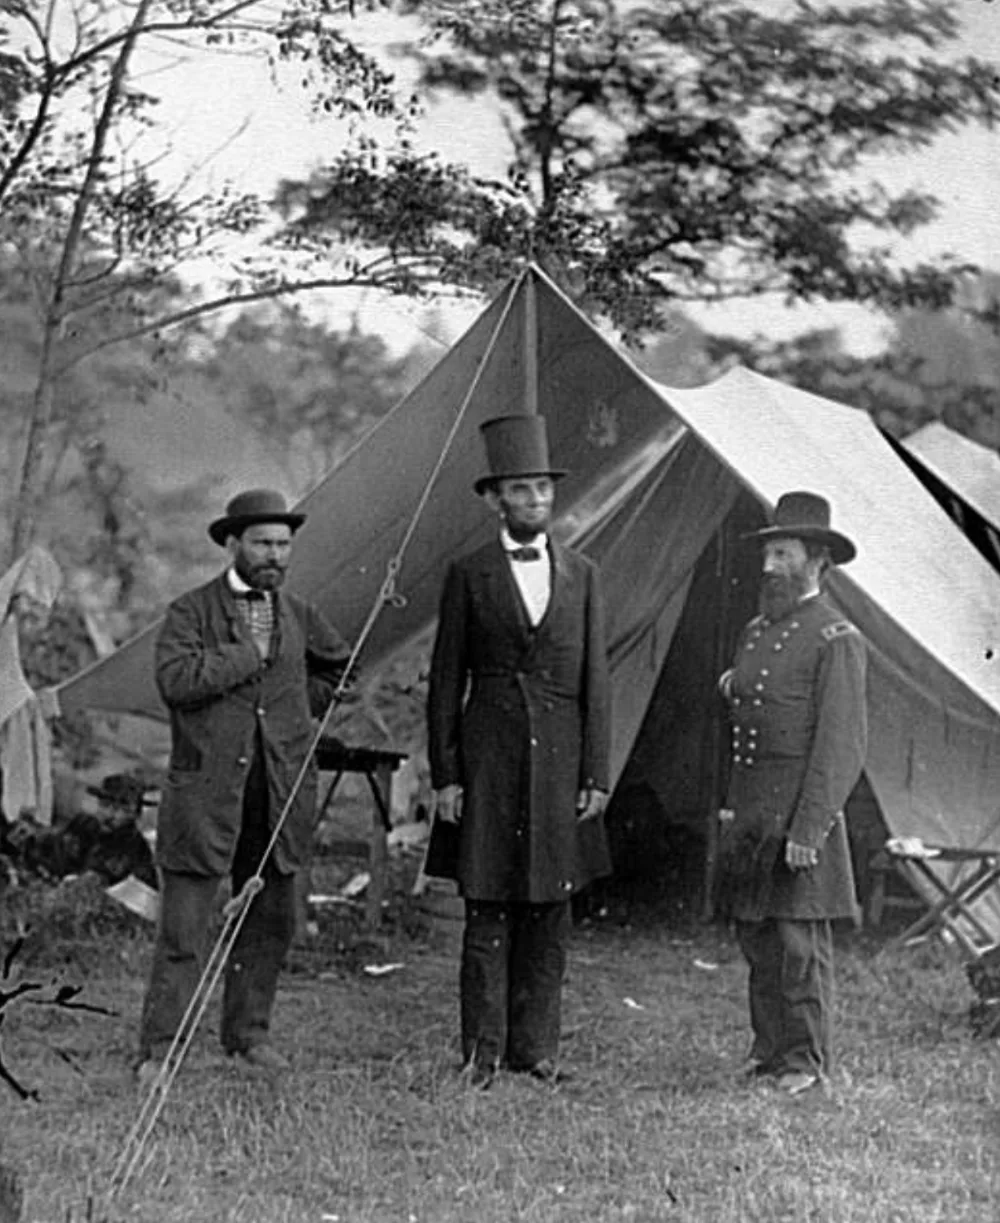 Vorher
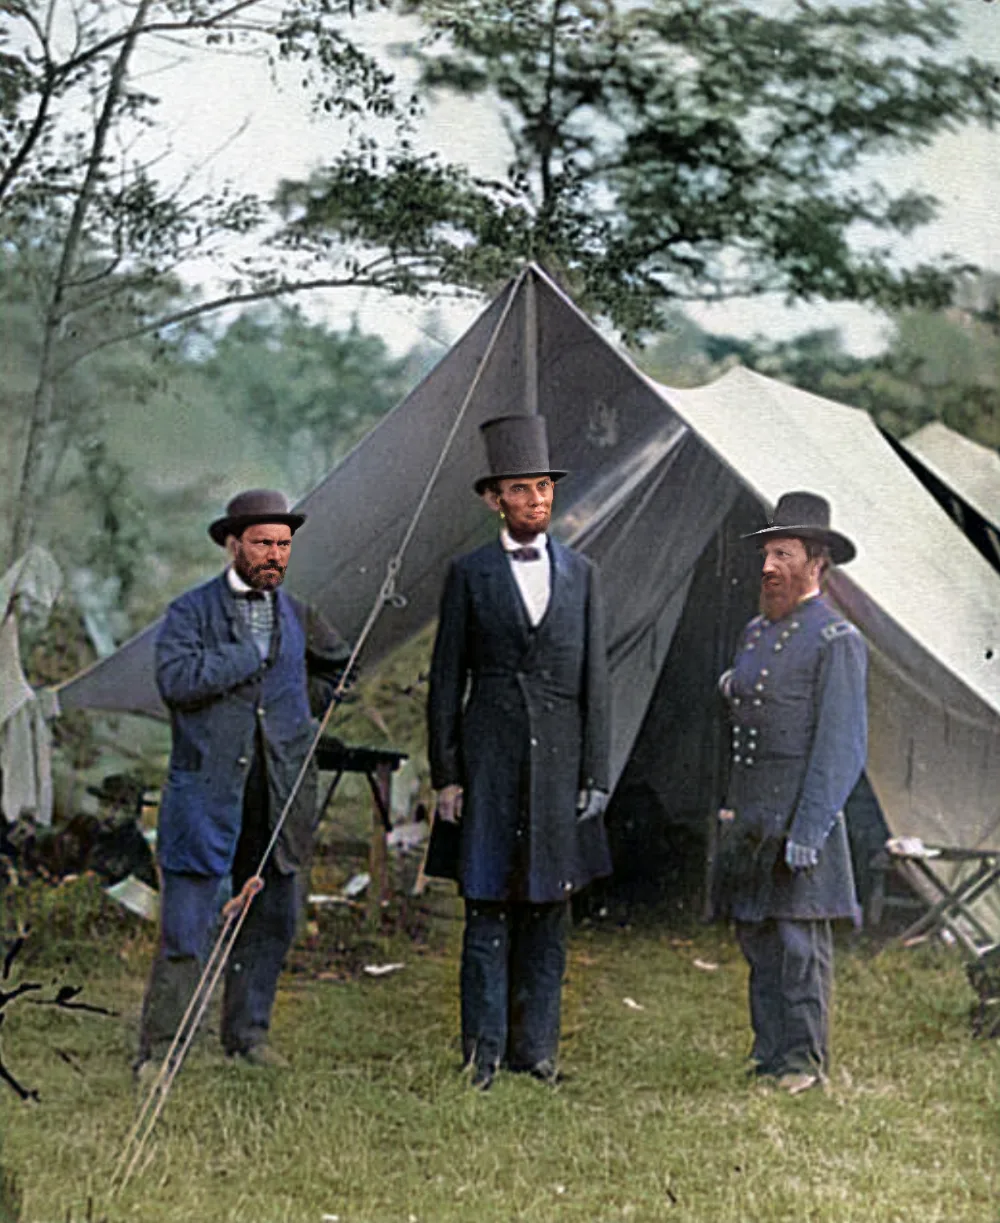 Nachher
1 · Die drei Ursachen
1. Vollständiger Ersatz. Die Standard-Pipeline klebt die Ausgabe des Modells mit 100 % Deckkraft über das Originalgesicht, sodass jedes restaurierte Gesicht vollständig vom Modell gezeichnet ist. Das Korn der Fotografie, die Papiertextur und der Charakter des Objektivs enden an einer unsichtbaren ovalen Grenze um jedes Gesicht.
2. Farbdrift. Das Gesichtsmodell gibt seine eigene Farbe aus, nicht die des Fotos. Auf unserer Testreihe gemessen, erfand es blaue Augen auf einer Ambrotypie aus den 1850ern und hellte den Hautton in einem Studioporträt eines Schwarzen aus dem 19. Jahrhundert auf, ein bekannter Fehlermodus von Gesichtsmodellen, die auf modernen, überwiegend hellhäutigen Fotokorpora trainiert wurden[2]. Jede Pipeline, die das Chroma des Modells behält, erbt seine Verzerrungen.
3. Kleine Gesichter sind Halluzinationen. Ein Gesicht, das weniger als etwa 100 px einnimmt, erreicht ein 512-px-Gesichtsmodell als 5–13-fache bilineare Vergrößerung, ein Schmierfleck. Das Modell erfindet dann ein plausibles Gesicht, statt das echte zurückzugewinnen. Das ist eine physikalische Grenze, keine Modellgrenze: Ein 40-px-Gesicht kann weich-aber-menschlich gemacht werden, nie scharf-und-originalgetreu.
2 · Anatomie einer Gesichtsreparatur
Um zu sehen, wo die Regler sitzen, folge einem Gesicht durch die Pipeline. Die Erkennung (SCRFD, mit der Plausibilitätsprüfung) liefert fünf Landmarken. Die Ausrichtung löst die Ähnlichkeitstransformation nach kleinsten Quadraten (Skalierung s, Rotation θ, Translation t), die die erkannten Augen- und Mundpunkte pi auf die feste FFHQ-Vorlage[5] qi abbildet:
sodass jedes Gesicht mit 512×512 und Augen und Mund in kanonischer Position ins Netz gelangt. Das Modell, standardmäßig CodeFormer[1], das restauriert, indem es Gesichter in einem gelernten Codebuch nachschlägt, statt Pixel zu regressieren, und ein Treuegewicht w ∈ [0, 1] bietet, das zwischen seinem Prior (0) und deinem Input (1) steuert, erzeugt einen restaurierten Ausschnitt. Dann kommt der Teil, um den es in dieser Notiz geht: die Rückeinfügung. Das klassische Rezept setzt diesen Ausschnitt mit voller Deckkraft in den Farben des Modells ein. Unseres verzerrt ihn an seinen Platz zurück unter einem radialen weichen Rand m und setzt jedes Pixel zusammen als
mit blend = 0,75, wobei faceL⊕photoab bedeutet, dass das Modell nur Luminanz beisteuert (Lab L), während die Fotografie ihr eigenes Chroma behält, das exakte Spiegelbild unseres Kolorierers, der nur Chroma beisteuert und die Luminanz des Fotos behält. Kleine Gesichter bekommen vor der Restaurierung einen eigenen ×4-Super-Resolution-Durchgang auf ihrer Quellfläche, sodass das Modell zurückgewonnene Details sieht statt eines bilinearen Schmierflecks.
3 · Die visuelle Testreihe, die Variante H auswählte
Acht Varianten, jede ein vollständiger Pipeline-Lauf über den Korpus, mit Variation von Treuegewicht, Deckkraft der Rückeinfügung, Farbquelle und Kleingesicht-SR. Die Ausgaben wurden bei 100 % Zoom Seite an Seite mit den Originalen verglichen:
| Variante | Gewicht | Rückeinfügung | Farbquelle | Kleingesicht-SR |
|---|---|---|---|---|
| A (damals aktuell) | 0,70 | 100 % | Modell | – |
| B | 0,90 | 100 % | Modell | – |
| C | 0,70 | 70 % | Modell | – |
| D | 0,70 | 100 % | Fotografie | – |
| E | 0,70 | 75 % | Fotografie | – |
| F | 0,85 | 75 % | Fotografie | – |
| G | 0,70 | 50 % | Fotografie | – |
| H (ausgewählt) | 0,70 | 75 % | Fotografie | ja |
H wurde als Standard-Rendering ausgeliefert. Die Rückeinfügung nur über die Luminanz kostet weniger als eine halbe Sekunde pro Foto; der Kleingesicht-Durchgang kostet ein bis zwei Sekunden, und nur pro qualifizierendem Gesicht. Der ursprüngliche Abschnitt zu den Einschränkungen gab die offensichtliche Schwäche zu: Die Auswahl erfolgte nach menschlichem Urteil im Seite-an-Seite-Vergleich an 35 Gesichtern, nicht nach einer Metrik. Also haben wir die metrische Testreihe gebaut.
4 · Neu: die Ablation, quantifiziert
Eine Zahl rahmt alles ein: Der degradierte Input selbst erzielt 0,950 Identität gegenüber dem Original. ArcFace wurde unter starker Augmentierung trainiert, es sieht also durch Unschärfe und Rauschen hindurch; die Restaurierung bekommt deshalb keinen Bonus dafür, scharf zu sein; sie wird nur belastet, wenn sie verändert, wer auf dem Foto ist. Jeder Renderer zahlt einen Teil dieser Identitätssteuer. Die Frage ist, wie viel:
| Rendering (alle bei w = 0,7) | PSNR (dB) | ArcFace-Id. | Identitätssteuer | Tenengrad-Verhältnis |
|---|---|---|---|---|
| Degradierter Input (Basislinie) | 27.32 | 0.950 | – | 0.217 |
| Classic v2 (100% paste, model colour) | 26.68 | 0.868 | −0.082 | 0.373 |
| + luma-only (photo keeps its chroma) | 26.72 | 0.882 | −0.068 | 0.376 |
| + 75% blend (grain shows through) | 27.06 | 0.901 | −0.049 | 0.304 |
| Natural (shipped: both + small-face SR) | 27.09 | 0.909 | −0.041 | 0.307 |
Die metrische Testreihe stimmt mit den Augen überein, Regler für Regler. Das Chroma der Fotografie zu behalten, kauft +0,014 Identität (die Farbdrift war real, und messbar). Die 75-%-Überblendung kauft weitere +0,019 und den größten Teil des PSNR: ein Viertel des echten Gesichts durchscheinen zu lassen, ist fast so viel wert wie die gesamte Treue-Einstellung des Gesichtsmodells. Zusammen halbieren sie die Identitätssteuer, von −0,082 auf −0,041, bei immer noch etwa 1,4-facher Schärfe des Inputs. Der eine ehrliche Preis: Das klassische Rendering ist nach Tenengrad „schärfer“ (0,373 vs. 0,307), eine Schärfe, die es teilweise für Textur ausgibt, die nicht die der Fotografie ist. Das ist der Perception-Distortion-Tradeoff[6], ins Rendering verlagert, und wir geben ihn für Identität aus.
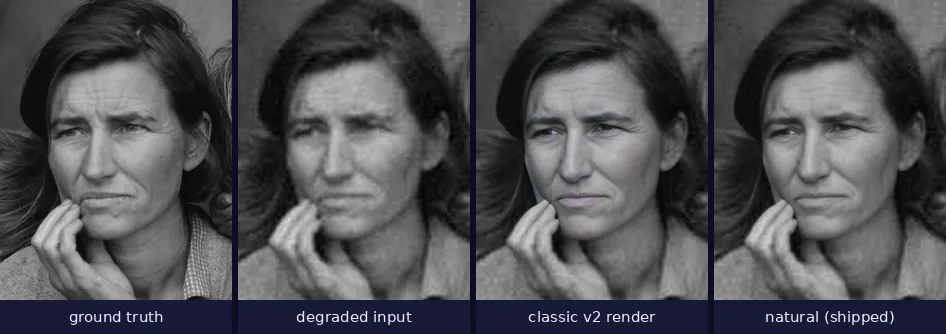
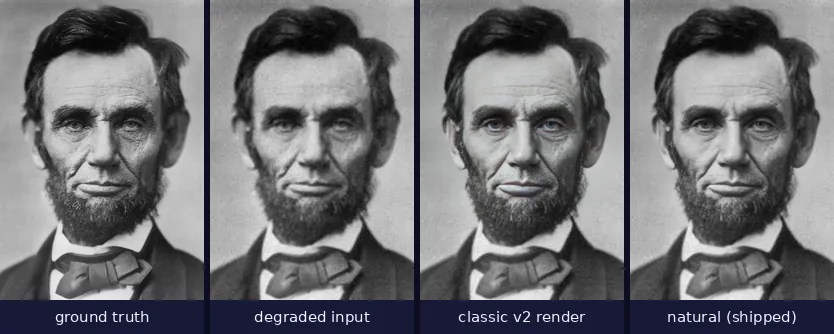
5 · Der Treue-Regler, von Ende zu Ende durchfahren
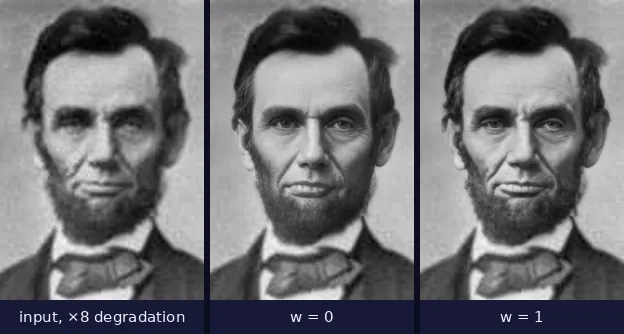
CodeFormers Gewicht w steuert zwischen dem Prior des Codebuchs (0) und der Rücksicht auf deinen Input (1)[1]. Wir haben es unter dem natürlichen Renderer in elf Schritten durchfahren:
Wir gingen hinein und erwarteten eine Tradeoff-Kurve mit einem inneren Optimum, das 0,7 als „das Knie“ rechtfertigen würde. Die Daten verweigerten sich: Nach den Zahlen dominiert w = 1,0, bei jedem Schweregrad:
Warum also 0,7 ausliefern statt 1,0? Weil die Metriken notwendig sind, nicht hinreichend. ArcFace misst, wer; für Alter und Textur ist es nahezu blind; dasselbe Training, das es robust gegen Unschärfe macht, macht es nachsichtig gegenüber Glättung. Die ursprüngliche Beobachtung der Testreihe steht auf eigenen Beinen: Beim üblichen Wert 0,5 des Modells werden die Krähenfüße auf Migrant Mother sichtbar weicher: Florence Owens Thompson war 32 und trug die Depression im Gesicht, und der Prior hätte es lieber, sie täte es nicht. Bei w = 1,0 gibt das Codebuch so weit einem ruinierten Input nach, dass Kompressionsmüll zu überleben beginnt. 0,7 behält fast den gesamten metrischen Wert (0,909 vs. 0,932), während die Bilder ihr Alter behalten. Und die s8-Tafel unten ist das Argument dafür, w bei beschädigten historischen Fotos nie in die Nähe von 0 zu lassen:
6 · Die anderen Modelle, derselbe Renderer
| Gesichtsmodell | PSNR (dB) | ArcFace-Id. | Tenengrad-Verhältnis | ms / Gesicht* |
|---|---|---|---|---|
| CodeFormer (w = 0.7, default) | 27.09 | 0.909 | 0.307 | 7200 |
| GFPGAN 1.4 | 27.13 | 0.910 | 0.328 | 6046 |
| GPEN-BFR-256 | 26.68 | 0.927 | 0.322 | 2633 |
*Median der Laufzeit des vollen Durchgangs (inklusive Erkennung) auf dem 2-vCPU-Testrechner. Unter dem natürlichen Renderer konvergieren die drei Modelle[1][2][3] auf 0,02 Identität zueinander: Der Renderer, nicht das Modell, ist jetzt der dominante Term, was selbst ein Befund ist: Der „Videospiel“-Look hatte nie wirklich damit zu tun, welches Netz man laufen lässt. CodeFormer bleibt der Standard wegen seiner Robustheit bei schweren Schäden und wegen des Reglers, dem diese Notiz gerade zwei Abschnitte gewidmet hat; GPEN bleibt mit 2,6 s pro Gesicht die Wahl für Geschwindigkeit.
7 · Einschränkungen
- Die visuelle Testreihe umfasst 35 Gesichter; die metrische Testreihe 4 Porträts × 120 Läufe. Die monotonen Verläufe galten für jedes Porträt einzeln; das ist die Behauptung, auf die wir uns stützen; absolute Werte werden mit Motiv und Scan schwanken.
- ArcFace ist ein einzelner Schiedsrichter, der Standard-Schiedsrichter, mit dem Vorbehalt der Unschärfetoleranz, den wir als Basislinie ausnutzen. Eine menschliche Wahrnehmungsstudie über Tausende von Gesichtern ist das fehlende Instrument, und die Beobachtung zu den Altersfalten beruht auf Augen, nicht auf Embeddings.
- Synthetische Degradation. Echte Schuhkarton-Schäden bringen Kratzer und Versilberung mit, die der Korruptions-Stack nicht modelliert; die Schadensstufe behandelt diese separat.
- Die Kleingesicht-Grenze bleibt bestehen: Unter etwa 40 px Gesicht erzeugt keine Einstellung ein originalgetreues scharfes Gesicht, und die ehrliche Ausgabe ist ein weiches.
Quellen
- Zhou, S., Chan, K. C. K., Li, C., & Loy, C. C. (2022). Towards Robust Blind Face Restoration with Codebook Lookup Transformer. NeurIPS 35. arXiv:2206.11253. arxiv.org
- Wang, X., Li, Y., Zhang, H., & Shan, Y. (2021). Towards Real-World Blind Face Restoration with Generative Facial Prior. CVPR. arXiv:2101.04061. arxiv.org
- Yang, T., Ren, P., Xie, X., & Zhang, L. (2021). GAN Prior Embedded Network for Blind Face Restoration in the Wild. CVPR. arXiv:2105.06070. arxiv.org
- Deng, J., Guo, J., Xue, N., & Zafeiriou, S. (2019). ArcFace: Additive Angular Margin Loss for Deep Face Recognition. CVPR. arXiv:1801.07698. arxiv.org
- Karras, T., Laine, S., & Aila, T. (2019). A Style-Based Generator Architecture for Generative Adversarial Networks (the FFHQ alignment template). CVPR. arXiv:1812.04948. arxiv.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- FaceFusion (open-source face processing platform): the reference implementation our SCRFD decode and model preprocessing are ported from, 1:1. github.com
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- Gardner, A. (1863). Abraham Lincoln, portrait O-77. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai