Por qué las caras restauradas con IA parecen personajes de videojuego
Los modelos de restauración facial pueden hacer que una cara de una foto dañada parezca un render de un videojuego antiguo: piel plástica, ojos pintados, una cara nítida pero que no es del todo la persona. Evaluamos ocho variantes de renderizado sobre 11 fotografías de dominio público para aislar las causas: son tres, son separables y ninguna se arregla con un “modelo mejor”. Esta revisión añade lo que le faltaba al banco original: números. Volver a medir el renderizado elegido con un embedding de reconocimiento facial[4] confirma cuantitativamente la selección a ojo (cada ajuste del renderizado “natural” compra identidad medible y reduce a la mitad el impuesto de identidad de la restauración), y un barrido completo del control de fidelidad muestra por qué se publica a 0.7 aunque todas las curvas sean monótonas hacia 1.0.
Cada cifra de esta nota se midió con el código del pipeline de producción: los mismos modelos, las mismas matemáticas. Registros brutos por imagen: e2v2_face.json · e2_face.json.
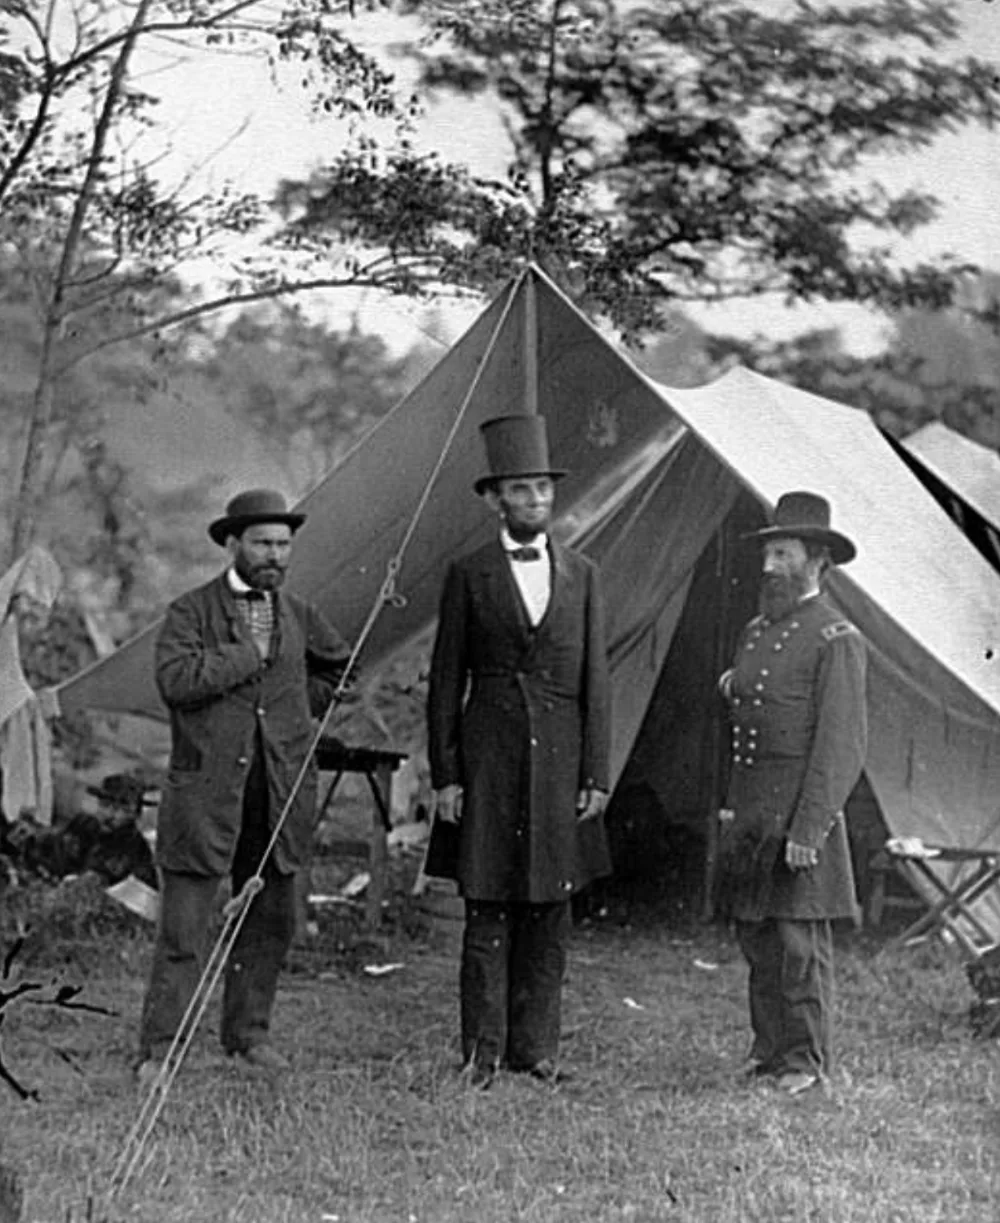 Antes
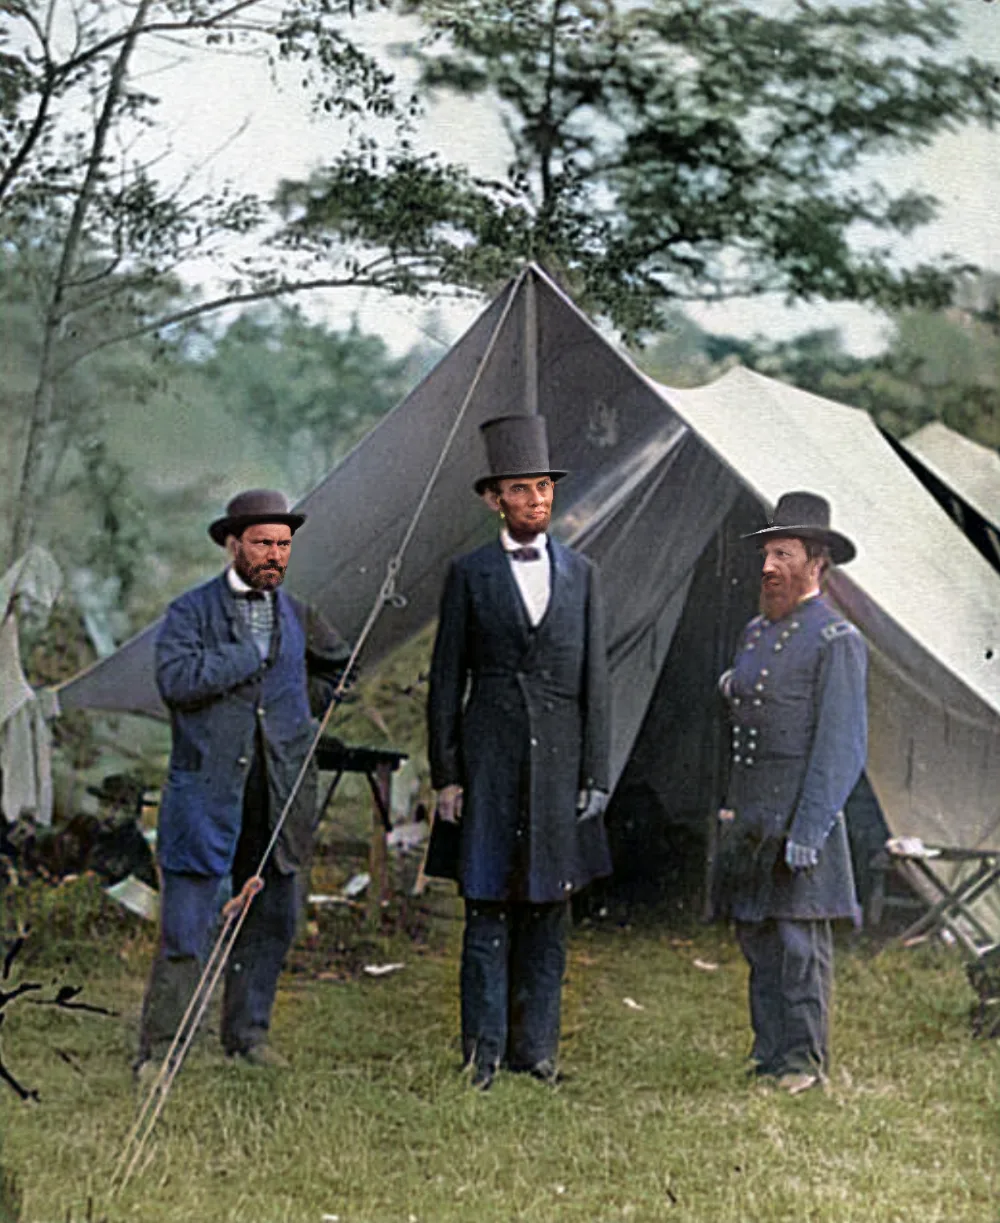 Después
1 · Las tres causas
1. Sustitución total. El pipeline estándar pega la salida del modelo sobre la cara original al 100% de opacidad, así que cada cara restaurada está dibujada por completo por el modelo. El grano de la fotografía, la textura del papel y el carácter del objetivo terminan en un límite ovalado invisible alrededor de cada cara.
2. Deriva de color. El modelo facial produce su propio color, no el de la foto. Medido en nuestro banco, inventó ojos azules en un ambrotipo de la década de 1850 y aclaró el tono de piel en un retrato de estudio del siglo XIX de un sujeto negro, un modo de fallo conocido de los modelos faciales entrenados con corpus fotográficos modernos y predominantemente de piel clara[2]. Cualquier pipeline que conserve el croma del modelo hereda sus sesgos.
3. Las caras pequeñas son alucinaciones. Una cara que ocupa menos de unos 100 px llega a un modelo facial de 512 px como una ampliación bilineal de 5–13×, un manchón. El modelo entonces inventa una cara plausible en lugar de recuperar la real. Es un límite físico, no del modelo: una cara de 40 px puede volverse suave pero humana, nunca nítida y fiel.
2 · Anatomía de una reparación facial
Para ver dónde están los ajustes, sigue una cara a través del pipeline. La detección (SCRFD, con el filtro de plausibilidad) produce cinco puntos clave. La alineación resuelve la transformación de semejanza por mínimos cuadrados (escala s, rotación θ, traslación t) que lleva los puntos detectados de ojos y boca pi sobre la plantilla fija FFHQ[5] qi:
de modo que cada cara entra en la red a 512×512 con ojos y boca en posición canónica. El modelo, CodeFormer por defecto[1], que restaura buscando caras en un libro de códigos aprendido en lugar de regresar píxeles, y que expone un peso de fidelidad w ∈ [0, 1] que oscila entre su prior (0) y tu entrada (1), produce un recorte restaurado. Luego viene la parte de la que trata esta nota: la reinserción. La receta clásica compone ese recorte a opacidad completa con los colores propios del modelo. La nuestra lo devuelve a su sitio bajo un difuminado radial m y compone cada píxel como
con blend = 0.75, y donde faceL⊕photoab significa que el modelo aporta solo luminancia (L de Lab) mientras la fotografía conserva su propio croma, el reflejo exacto de nuestro colorizador, que aporta solo croma y conserva la luminancia de la foto. Las caras pequeñas reciben una pasada dedicada de superresolución ×4 sobre su huella original antes de la restauración, para que el modelo vea detalle recuperado en lugar de un manchón bilineal.
3 · El banco visual que eligió la variante H
Ocho variantes, cada una una ejecución completa del pipeline sobre el corpus, variando el peso de fidelidad, la opacidad de la reinserción, la fuente del color y la superresolución de caras pequeñas. Las salidas se compararon lado a lado con los originales al 100% de zoom:
| Variante | Peso | Reinserción | Fuente del color | SR de caras pequeñas |
|---|---|---|---|---|
| A (la de entonces) | 0.70 | 100% | modelo | – |
| B | 0.90 | 100% | modelo | – |
| C | 0.70 | 70% | modelo | – |
| D | 0.70 | 100% | fotografía | – |
| E | 0.70 | 75% | fotografía | – |
| F | 0.85 | 75% | fotografía | – |
| G | 0.70 | 50% | fotografía | – |
| H (seleccionada) | 0.70 | 75% | fotografía | sí |
H se publicó como renderizado por defecto. La reinserción solo de luminancia añade menos de medio segundo por foto; la pasada de caras pequeñas añade uno o dos segundos solo por cada cara que la requiere. La sección de limitaciones original admitía la debilidad evidente: la selección se hizo por juicio humano lado a lado sobre 35 caras, no con una métrica. Así que construimos el banco métrico.
4 · Nuevo: la ablación, cuantificada
Un número lo enmarca todo: la propia entrada degradada puntúa 0.950 de identidad contra el original. ArcFace se entrenó con aumentación intensa, así que ve a través del desenfoque y el ruido; la restauración, por tanto, no recibe crédito por ser nítida; solo se le descuenta cuando cambia quién está en la foto. Todo renderizador paga parte de ese impuesto de identidad. La pregunta es cuánto:
| Renderizado (todos a w = 0.7) | PSNR (dB) | id. ArcFace | impuesto de identidad | cociente Tenengrad |
|---|---|---|---|---|
| Entrada degradada (referencia) | 27.32 | 0.950 | – | 0.217 |
| Classic v2 (100% paste, model colour) | 26.68 | 0.868 | −0.082 | 0.373 |
| + luma-only (photo keeps its chroma) | 26.72 | 0.882 | −0.068 | 0.376 |
| + 75% blend (grain shows through) | 27.06 | 0.901 | −0.049 | 0.304 |
| Natural (shipped: both + small-face SR) | 27.09 | 0.909 | −0.041 | 0.307 |
El banco métrico coincide con los ojos, ajuste por ajuste. Conservar el croma de la fotografía compra +0.014 de identidad (la deriva de color era real, y medible). La mezcla al 75% compra otros +0.019 y la mayor parte del PSNR: dejar que una cuarta parte de la cara verdadera se transparente vale casi tanto como todo el ajuste de fidelidad del modelo facial. Juntos reducen a la mitad el impuesto de identidad, de −0.082 a −0.041, manteniendo todavía unas 1.4× la nitidez de la entrada. El único coste honesto: el render clásico es “más nítido” según Tenengrad (0.373 frente a 0.307), una nitidez que gasta en parte en textura que no es de la fotografía. Ese es el compromiso percepción–distorsión[6] trasladado al renderizado, y nosotros lo gastamos en identidad.
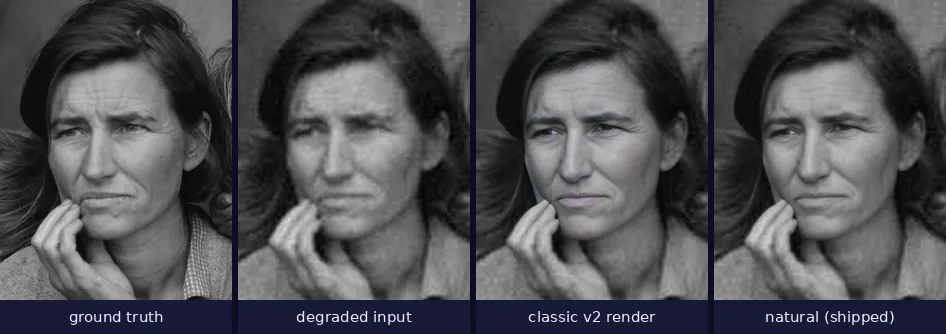
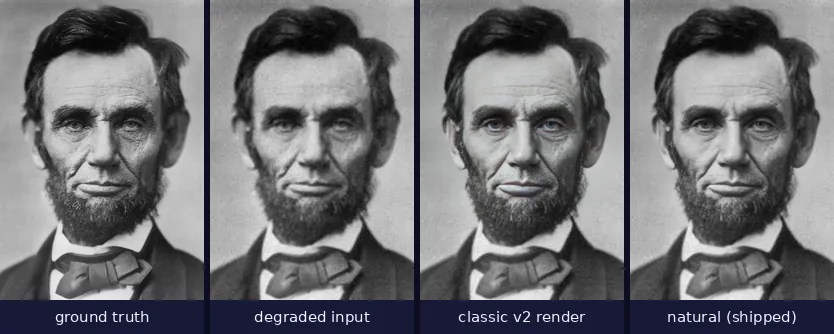
5 · El control de fidelidad, barrido de extremo a extremo
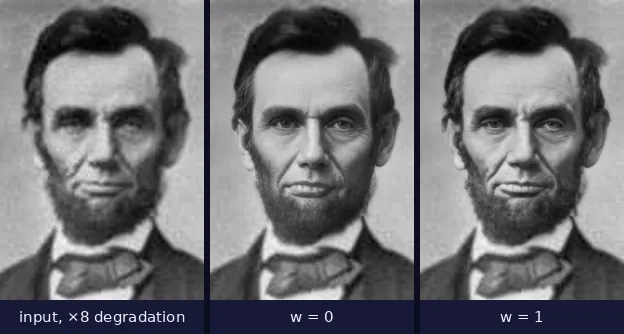
El peso w de CodeFormer oscila entre el prior del libro de códigos (0) y la deferencia a tu entrada (1)[1]. Lo barrimos en once pasos bajo el renderizador natural:
Entramos esperando una curva de compromiso con un óptimo interior que justificara 0.7 como “el codo”. Los datos se negaron: en los números, w = 1.0 domina, a todas las severidades:
Entonces, ¿por qué publicar 0.7 en lugar de 1.0? Porque las métricas son necesarias, no suficientes. ArcFace mide quién; es casi ciego a la edad y a la textura; el mismo entrenamiento que lo hace robusto al desenfoque lo hace indulgente con el suavizado. La observación original del banco se sostiene con su propia evidencia: al 0.5 habitual del modelo, las patas de gallo se suavizan visiblemente en Madre migrante: Florence Owens Thompson tenía 32 años y llevaba la Depresión en la cara, y el prior preferiría que no fuera así. A w = 1.0 el libro de códigos cede tanto ante una entrada arruinada que empieza a sobrevivir basura de compresión. 0.7 conserva casi todo el valor métrico (0.909 frente a 0.932) mientras las imágenes conservan su edad. Y el panel s8 de abajo es el argumento para no dejar nunca w cerca de 0 en fotos patrimoniales dañadas:
6 · Los otros modelos, mismo renderizador
| Modelo facial | PSNR (dB) | id. ArcFace | cociente Tenengrad | ms / cara* |
|---|---|---|---|---|
| CodeFormer (w = 0.7, default) | 27.09 | 0.909 | 0.307 | 7200 |
| GFPGAN 1.4 | 27.13 | 0.910 | 0.328 | 6046 |
| GPEN-BFR-256 | 26.68 | 0.927 | 0.322 | 2633 |
*Tiempo de reloj mediano de la pasada completa (detección incluida) en la máquina del banco de 2 vCPU. Bajo el renderizador natural, los tres modelos[1][2][3] convergen a menos de 0.02 de identidad entre sí: el renderizador, no el modelo, es ahora el término dominante, lo que es en sí un hallazgo: el aspecto de “videojuego” nunca fue realmente cuestión de qué red ejecutas. CodeFormer sigue siendo el modelo por defecto por su robustez ante daños graves y por el control al que esta nota acaba de dedicar dos secciones; GPEN sigue siendo la opción rápida, a 2.6 s por cara.
7 · Limitaciones
- El banco visual son 35 caras; el banco métrico, 4 retratos × 120 ejecuciones. Las formas monótonas se mantuvieron en cada retrato por separado; esa es la afirmación en la que nos apoyamos; los valores absolutos variarán con el sujeto y el escaneo.
- ArcFace es un solo árbitro, el estándar, con la salvedad de la tolerancia al desenfoque que explotamos como referencia. Un estudio perceptual humano sobre miles de caras es el instrumento que falta, y la observación sobre las líneas de la edad se apoya en ojos, no en embeddings.
- Degradación sintética. Los daños reales de la caja de zapatos añaden rayones y espejado de plata que la pila de corrupción no modela; la etapa de daños los trata por separado.
- El límite de las caras pequeñas se mantiene: por debajo de unos 40 px de cara, ningún ajuste produce una cara nítida y fiel, y la salida honesta es una suave.
Referencias
- Zhou, S., Chan, K. C. K., Li, C., & Loy, C. C. (2022). Towards Robust Blind Face Restoration with Codebook Lookup Transformer. NeurIPS 35. arXiv:2206.11253. arxiv.org
- Wang, X., Li, Y., Zhang, H., & Shan, Y. (2021). Towards Real-World Blind Face Restoration with Generative Facial Prior. CVPR. arXiv:2101.04061. arxiv.org
- Yang, T., Ren, P., Xie, X., & Zhang, L. (2021). GAN Prior Embedded Network for Blind Face Restoration in the Wild. CVPR. arXiv:2105.06070. arxiv.org
- Deng, J., Guo, J., Xue, N., & Zafeiriou, S. (2019). ArcFace: Additive Angular Margin Loss for Deep Face Recognition. CVPR. arXiv:1801.07698. arxiv.org
- Karras, T., Laine, S., & Aila, T. (2019). A Style-Based Generator Architecture for Generative Adversarial Networks (the FFHQ alignment template). CVPR. arXiv:1812.04948. arxiv.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- FaceFusion (open-source face processing platform): the reference implementation our SCRFD decode and model preprocessing are ported from, 1:1. github.com
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- Gardner, A. (1863). Abraham Lincoln, portrait O-77. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai