Dlaczego twarze odnowione przez AI wyglądają jak postacie z gry wideo
Modele odnawiania twarzy potrafią sprawić, że twarz z uszkodzonego zdjęcia wygląda jak render ze starej gry wideo: plastikowa skóra, namalowane oczy, twarz ostra, ale nie do końca ta osoba. Przetestowaliśmy osiem wariantów renderowania na 11 fotografiach z domeny publicznej, żeby wyodrębnić przyczyny: są trzy, dają się rozdzielić i żadnej nie naprawia „lepszy model”. Ta rewizja dodaje to, czego brakowało pierwotnemu testowi: liczby. Ponowny pomiar wybranego renderowania osadzeniem rozpoznawania twarzy[4] ilościowo potwierdza wybór dokonany na oko (każde pokrętło „naturalnego” renderowania kupuje mierzalną tożsamość, tnąc podatek od tożsamości renowacji o połowę), a pełne przemiatanie pokrętła wierności pokazuje, czemu wdrożono 0,7, choć każda krzywa rośnie monotonicznie w stronę 1,0.
Każda liczba w tej notatce została zmierzona na kodzie produkcyjnego potoku: te same modele, ta sama matematyka. Surowe rekordy dla każdego obrazu: e2v2_face.json · e2_face.json.
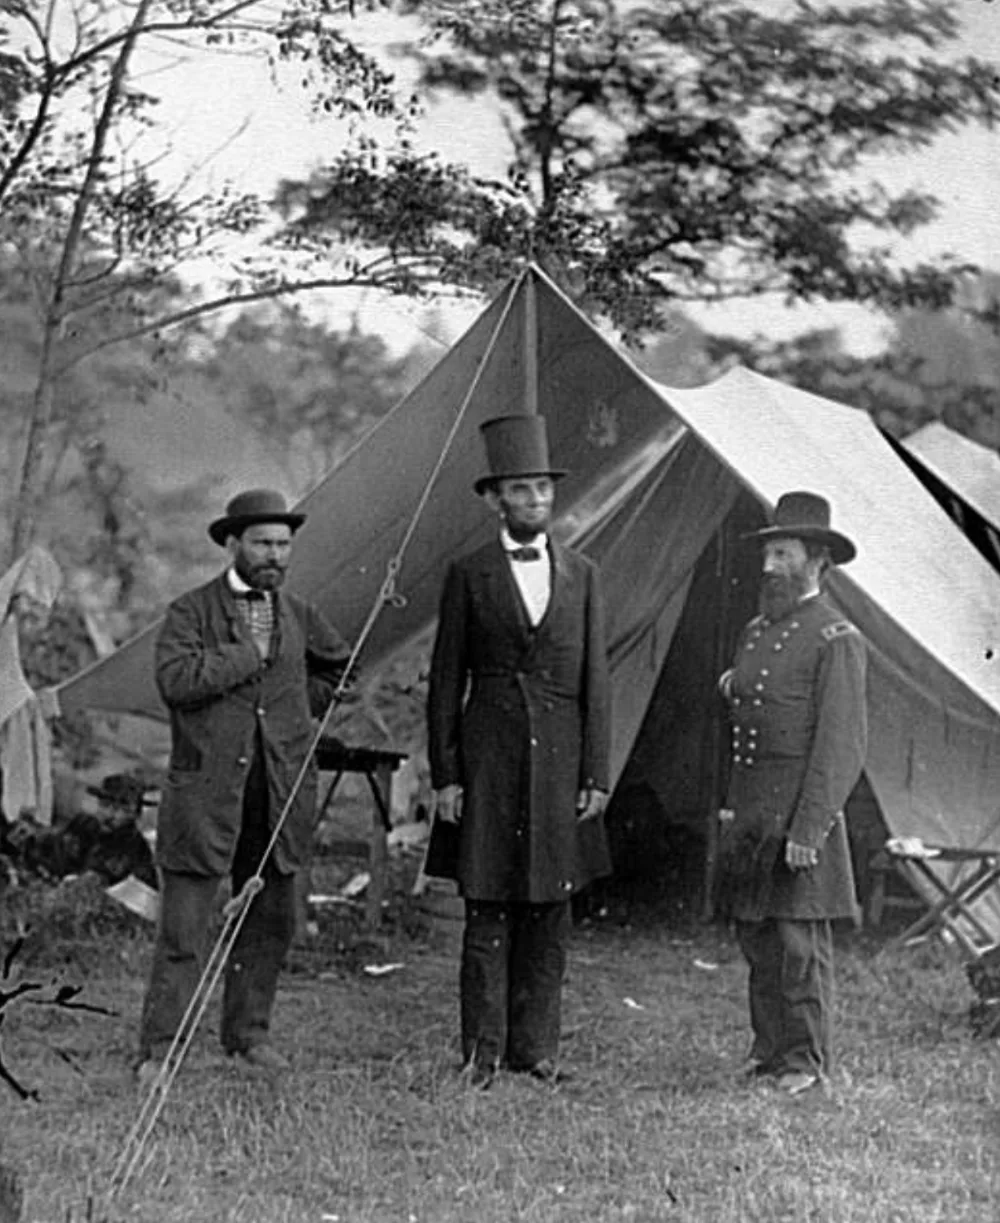 Przed
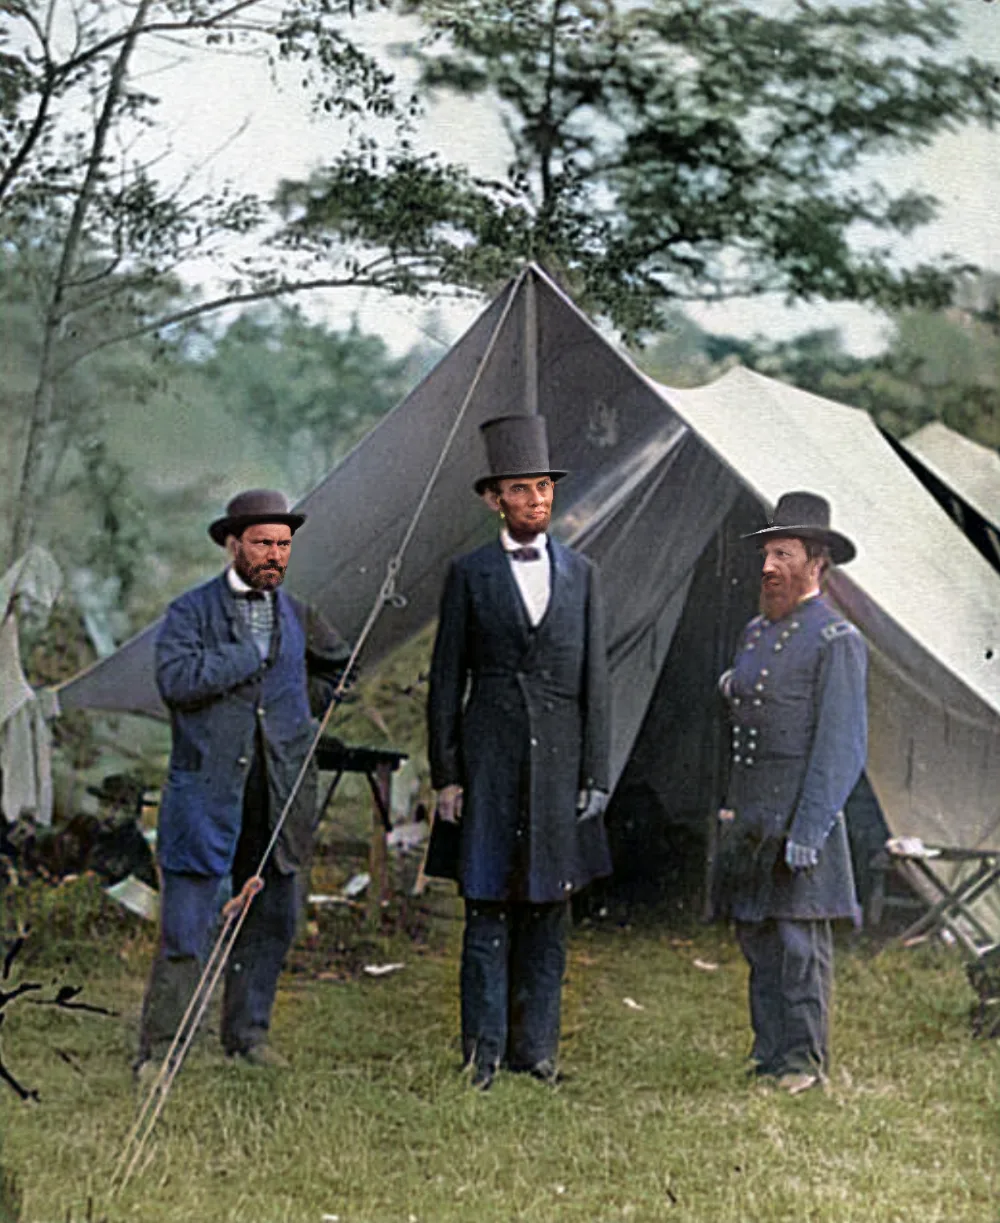 Po
1 · Trzy przyczyny
1. Całkowite zastąpienie. Standardowy potok wkleja wyjście modelu na oryginalną twarz przy 100% krycia, więc każda odnowiona twarz jest w całości narysowana przez model. Ziarno fotografii, faktura papieru i charakter obiektywu kończą się na niewidocznej owalnej granicy wokół każdej twarzy.
2. Dryf koloru. Model twarzy zwraca własny kolor, nie kolor zdjęcia. Na naszym stanowisku testowym wymyślił niebieskie oczy na ambrotypii z lat 1850. i rozjaśnił odcień skóry na XIX-wiecznym portrecie studyjnym czarnoskórej osoby, znany tryb awarii modeli twarzy trenowanych na współczesnych korpusach zdjęć z przewagą jasnej skóry[2]. Każdy potok, który zachowuje chrominancję modelu, dziedziczy jego uprzedzenia.
3. Małe twarze to halucynacje. Twarz zajmująca mniej niż około 100 px dociera do modelu twarzy 512 px jako biliniowe powiększenie 5–13×, czyli rozmaz. Model wymyśla wtedy wiarygodną twarz, zamiast odzyskać prawdziwą. To granica fizyki, nie modelu: twarz 40 px może stać się miękka, ale ludzka, nigdy ostra i wierna.
2 · Anatomia naprawy twarzy
Żeby zobaczyć, gdzie siedzą pokrętła, prześledź jedną twarz przez potok. Detekcja (SCRFD, z bramką wiarygodności) daje pięć punktów charakterystycznych. Wyrównanie rozwiązuje metodą najmniejszych kwadratów przekształcenie podobieństwa (skala s, obrót θ, przesunięcie t), odwzorowujące wykryte punkty oczu i ust pi na stały szablon FFHQ[5] qi:
więc każda twarz wchodzi do sieci jako 512×512 z oczami i ustami w kanonicznej pozycji. Model, domyślnie CodeFormer[1], który odnawia, wyszukując twarze w wyuczonej książce kodowej, zamiast regresować piksele, i udostępnia wagę wierności w ∈ [0, 1] sterującą między jego priorem (0) a Twoim wejściem (1), wytwarza odnowiony wycinek. Potem następuje część, o której jest ta notatka: wklejanie z powrotem. Klasyczny przepis komponuje ten wycinek przy pełnym kryciu, w kolorach modelu. Nasz wypacza go z powrotem na miejsce pod promieniową maską wygładzającą m i komponuje każdy piksel jako
gdzie blend = 0,75, a faceL⊕photoab oznacza, że model wnosi tylko luminancję (L z Lab), podczas gdy fotografia zachowuje własną chrominancję, dokładne lustrzane odbicie naszego koloryzatora, który wnosi tylko chrominancję i zachowuje luminancję zdjęcia. Małe twarze dostają przed odnawianiem dedykowany przebieg superrozdzielczości ×4 na swoim źródłowym obszarze, więc model widzi odzyskane detale zamiast biliniowego rozmazu.
3 · Test wizualny, który wybrał wariant H
Osiem wariantów, każdy jako pełny przebieg potoku na korpusie, z różną wagą wierności, kryciem wklejania, źródłem koloru i SR małych twarzy. Wyniki porównywano obok siebie z oryginałami przy powiększeniu 100%:
| Wariant | Waga | Wklejanie | Źródło koloru | SR małych twarzy |
|---|---|---|---|---|
| A (ówczesny) | 0,70 | 100% | model | – |
| B | 0,90 | 100% | model | – |
| C | 0,70 | 70% | model | – |
| D | 0,70 | 100% | fotografia | – |
| E | 0,70 | 75% | fotografia | – |
| F | 0,85 | 75% | fotografia | – |
| G | 0,70 | 50% | fotografia | – |
| H (wybrany) | 0,70 | 75% | fotografia | tak |
H trafił do produkcji jako domyślne renderowanie. Wklejanie tylko w luminancji dodaje mniej niż pół sekundy na zdjęcie; przebieg dla małych twarzy dodaje jedną do dwóch sekund tylko na każdą kwalifikującą się twarz. Pierwotna sekcja o ograniczeniach przyznawała oczywistą słabość: wybór opierał się na ludzkim osądzie obok siebie na 35 twarzach, nie na metryce. Zbudowaliśmy więc test metryczny.
4 · Nowość: ablacja w liczbach
Jedna liczba ustawia wszystko: samo zdegradowane wejście ma tożsamość 0,950 względem oryginału. ArcFace trenowano z mocną augmentacją, więc przenika rozmycie i szum; renowacja nie dostaje więc punktów za ostrość; jest obciążana tylko wtedy, gdy zmienia to, kto jest na zdjęciu. Każdy renderer płaci część tego podatku od tożsamości. Pytanie brzmi: ile:
| Renderowanie (wszystkie przy w = 0,7) | PSNR (dB) | id ArcFace | podatek od tożsamości | wskaźnik Tenengrada |
|---|---|---|---|---|
| Zdegradowane wejście (linia bazowa) | 27.32 | 0.950 | – | 0.217 |
| Classic v2 (100% paste, model colour) | 26.68 | 0.868 | −0.082 | 0.373 |
| + luma-only (photo keeps its chroma) | 26.72 | 0.882 | −0.068 | 0.376 |
| + 75% blend (grain shows through) | 27.06 | 0.901 | −0.049 | 0.304 |
| Natural (shipped: both + small-face SR) | 27.09 | 0.909 | −0.041 | 0.307 |
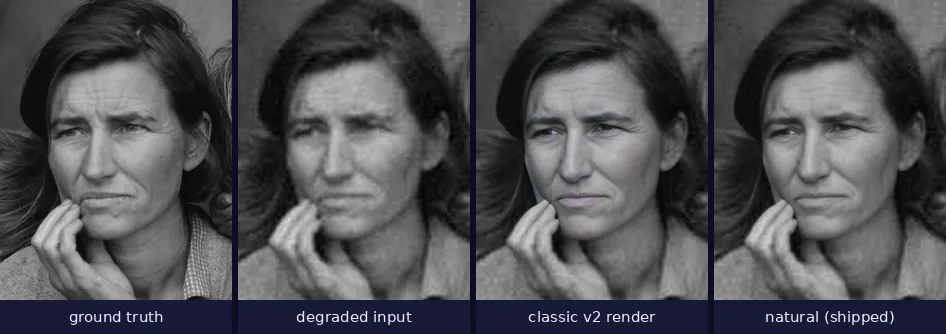
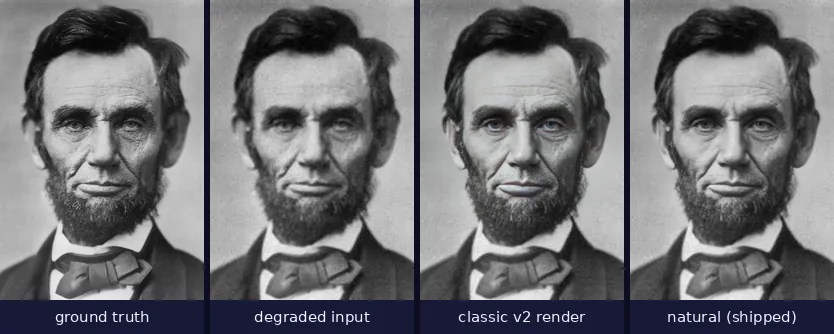
Test metryczny zgadza się z oczami, pokrętło po pokrętle. Zachowanie chrominancji fotografii kupuje +0,014 tożsamości (dryf koloru był prawdziwy i mierzalny). Mieszanie 75% kupuje kolejne +0,019 i większość PSNR: przepuszczenie jednej czwartej prawdziwej twarzy jest warte prawie tyle, co całe ustawienie wierności modelu twarzy. Razem zmniejszają podatek od tożsamości o połowę, z −0,082 do −0,041, wciąż przy mniej więcej 1,4× ostrości wejścia. Jedyny uczciwy koszt: render klasyczny jest „ostrzejszy” według Tenengrada (0,373 wobec 0,307), a tę ostrość częściowo wydaje na fakturę, która nie jest fakturą fotografii. To kompromis percepcja–zniekształcenie[6] przeniesiony do renderowania, a my wydajemy go na tożsamość.
5 · Pokrętło wierności, przemiecione od końca do końca
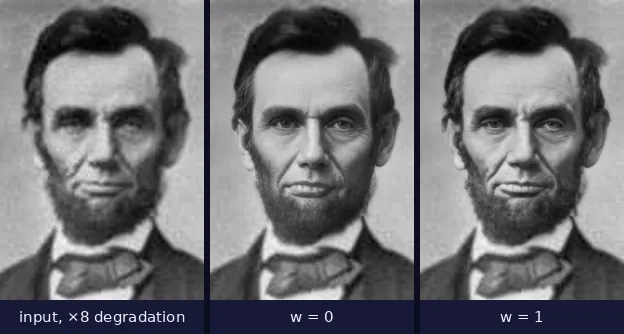
Waga w CodeFormera steruje między priorem książki kodowej (0) a uległością wobec Twojego wejścia (1)[1]. Przemietliśmy ją w jedenastu krokach pod naturalnym rendererem:
Weszliśmy w to, spodziewając się krzywej kompromisu z wewnętrznym optimum, które uzasadniłoby 0,7 jako „kolano”. Dane odmówiły: w liczbach w = 1,0 dominuje, przy każdym nasileniu:
Czemu więc wdrażać 0,7 zamiast 1,0? Bo metryki są konieczne, ale niewystarczające. ArcFace mierzy kto; jest niemal ślepy na wiek i fakturę; ten sam trening, który czyni go odpornym na rozmycie, czyni go wyrozumiałym dla wygładzania. Pierwotna obserwacja testu broni się własnymi dowodami: przy zwyczajowym dla modelu 0,5 kurze łapki na Migrant Mother wyraźnie miękną: Florence Owens Thompson miała 32 lata i nosiła Wielki Kryzys na twarzy, a prior wolałby, żeby nie nosiła. Przy w = 1,0 książka kodowa ulega tak daleko zrujnowanemu wejściu, że zaczynają przeżywać śmieci kompresji. 0,7 zachowuje niemal całą wartość metryczną (0,909 wobec 0,932), a zdjęcia zachowują swój wiek. A panel s8 poniżej jest argumentem, by nigdy nie zbliżać w do 0 na uszkodzonych zdjęciach z rodzinnego dziedzictwa:
6 · Pozostałe modele, ten sam renderer
| Model twarzy | PSNR (dB) | id ArcFace | wskaźnik Tenengrada | ms / twarz* |
|---|---|---|---|---|
| CodeFormer (w = 0.7, default) | 27.09 | 0.909 | 0.307 | 7200 |
| GFPGAN 1.4 | 27.13 | 0.910 | 0.328 | 6046 |
| GPEN-BFR-256 | 26.68 | 0.927 | 0.322 | 2633 |
*Mediana czasu rzeczywistego pełnego przebiegu (z detekcją) na maszynie testowej 2 vCPU. Pod naturalnym rendererem trzy modele[1][2][3] zbiegają się do 0,02 tożsamości od siebie: renderer, nie model, jest teraz dominującym składnikiem, co samo w sobie jest odkryciem: wygląd „jak z gry wideo” nigdy tak naprawdę nie zależał od tego, którą sieć uruchamiasz. CodeFormer pozostaje domyślny ze względu na odporność na ciężkie uszkodzenia i na pokrętło, któremu ta notatka właśnie poświęciła dwie sekcje; GPEN pozostaje wyborem dla szybkości przy 2,6 s na twarz.
7 · Ograniczenia
- Test wizualny to 35 twarzy; test metryczny to 4 portrety × 120 przebiegów. Monotoniczne kształty utrzymały się na każdym portrecie z osobna; to twierdzenie, na którym polegamy; wartości bezwzględne będą się przesuwać wraz z osobą i skanem.
- ArcFace to jeden sędzia, ten standardowy, z zastrzeżeniem o tolerancji na rozmycie, które wykorzystujemy jako linię bazową. Brakującym instrumentem jest ludzkie badanie percepcyjne na tysiącach twarzy, a obserwacja o zmarszczkach opiera się na oczach, nie na osadzeniach.
- Syntetyczna degradacja. Prawdziwe uszkodzenia z pudełka po butach dodają rysy i srebrzenie, których stos zniekształceń nie modeluje; etap naprawy uszkodzeń obsługuje je osobno.
- Granica małych twarzy pozostaje: poniżej około 40 px twarzy żadne ustawienie nie daje wiernej, ostrej twarzy, a uczciwym wynikiem jest twarz miękka.
Źródła
- Zhou, S., Chan, K. C. K., Li, C., & Loy, C. C. (2022). Towards Robust Blind Face Restoration with Codebook Lookup Transformer. NeurIPS 35. arXiv:2206.11253. arxiv.org
- Wang, X., Li, Y., Zhang, H., & Shan, Y. (2021). Towards Real-World Blind Face Restoration with Generative Facial Prior. CVPR. arXiv:2101.04061. arxiv.org
- Yang, T., Ren, P., Xie, X., & Zhang, L. (2021). GAN Prior Embedded Network for Blind Face Restoration in the Wild. CVPR. arXiv:2105.06070. arxiv.org
- Deng, J., Guo, J., Xue, N., & Zafeiriou, S. (2019). ArcFace: Additive Angular Margin Loss for Deep Face Recognition. CVPR. arXiv:1801.07698. arxiv.org
- Karras, T., Laine, S., & Aila, T. (2019). A Style-Based Generator Architecture for Generative Adversarial Networks (the FFHQ alignment template). CVPR. arXiv:1812.04948. arxiv.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- FaceFusion (open-source face processing platform): the reference implementation our SCRFD decode and model preprocessing are ported from, 1:1. github.com
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- Gardner, A. (1863). Abraham Lincoln, portrait O-77. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai