Ampliación con IA vs bicúbica: un benchmark de 28 imágenes
Toda herramienta de fotos promete ahora “mejorar”. La nuestra ejecuta Real-ESRGAN[1], así que le debíamos una respuesta a una pregunta incómoda: cuando mides como mide la literatura de procesamiento de imágenes, ¿la IA supera de verdad a la simple interpolación bicúbica? El resultado es el tipo de respuesta más interesante (no, y también rotundamente sí), y la división entre esas dos respuestas tiene nombre en la literatura: el compromiso percepción–distorsión[3]. Esta nota muestra el benchmark completo, incluido el caso en que la IA pierde estrepitosamente (el grano de película), y por qué publicamos de todos modos el modelo que pierde el benchmark clásico.
Cada cifra de esta nota se midió con el código del pipeline de producción: los mismos modelos, las mismas matemáticas. Registros brutos por imagen: e1_sr.json.
1 · Método
El corpus es la Kodak Lossless True Color Suite de 24 imágenes[4] (el conjunto de referencia de 768×512 en el que la literatura de compresión y superresolución se ha apoyado durante tres décadas), más cuatro recortes de 768×512 de escaneos de alta resolución de fotografías históricas, incluida Madre migrante de Dorothea Lange, de 1936[5], porque este sitio existe para fotos antiguas y las fotos antiguas tienen grano de película. Esa distinción decide la Sección 3.
Puntuamos tres cosas. Fidelidad, como relación señal-ruido de pico sobre RGB:
similitud estructural (SSIM[2], luma, la ventana gaussiana estándar de 11×11, σ = 1.5, K₁ = 0.01, K₂ = 0.03):
y nitidez como la medida Tenengrad (magnitud media al cuadrado del gradiente de Sobel), expresada como cociente de restauración, Tenengrad(salida) ÷ Tenengrad(verdad de referencia). Un cociente de 1.0 significaría que la reconstrucción lleva tanta energía de bordes como la fotografía original.
2 · Resultados: el compromiso, en vivo
En la métrica que todo el mundo publica, la escalera clásica se comporta exactamente como predice la teoría del muestreo (cada núcleo mejor compra una fracción de decibelio), y Real-ESRGAN queda penúltimo:
| Método | PSNR (dB) | σ | SSIM | cociente Tenengrad | ms / imagen* |
|---|---|---|---|---|---|
| Vecino más cercano | 25.42 | ±3.42 | 0.673 | 0.382 | 8 |
| Bilineal | 25.88 | ±3.62 | 0.687 | 0.152 | 236 |
| Bicúbica (Catmull-Rom) | 26.29 | ±3.68 | 0.705 | 0.196 | 343 |
| Lanczos-3 | 26.45 | ±3.71 | 0.711 | 0.216 | 876 |
| Real-ESRGAN ×4 (el nuestro) | 25.38 | ±3.16 | 0.711 | 0.676 | 462 |
*Entrada de 192×128, hardware de clase contenedor de 2 vCPU; los cocientes se trasladan, los milisegundos no. Si el PSNR fuera toda la historia, publicaríamos Lanczos-3 y borraríamos 4.9 MB de red neuronal. Pero traza cada método en el eje de fidelidad contra el eje de nitidez y el conjunto se divide en dos especies:
SSIM (diseñado para seguir la estructura percibida y no el error bruto[2]) parte la diferencia y se pone, por poco, del lado del modelo: la mejor media del conjunto en general, y un 0.704 frente a 0.694 más claro en el subconjunto Kodak, donde domina la textura fina. ¿Por qué la interpolación no puede competir en nitidez? Porque todo núcleo clásico es un operador lineal e invariante al desplazamiento: solo puede redistribuir las frecuencias que sobrevivieron a la reducción, nunca crear las que no. El límite de Nyquist no es una sugerencia. Un prior GAN esquiva el límite cambiando la pregunta: de “¿qué señal produjo estas muestras?” (incontestable) a “de todas las imágenes naturales que se reducirían a esto, ¿cuál es la más plausible?”[1] Y ahí vive exactamente también su riesgo: plausible no es verdadero.
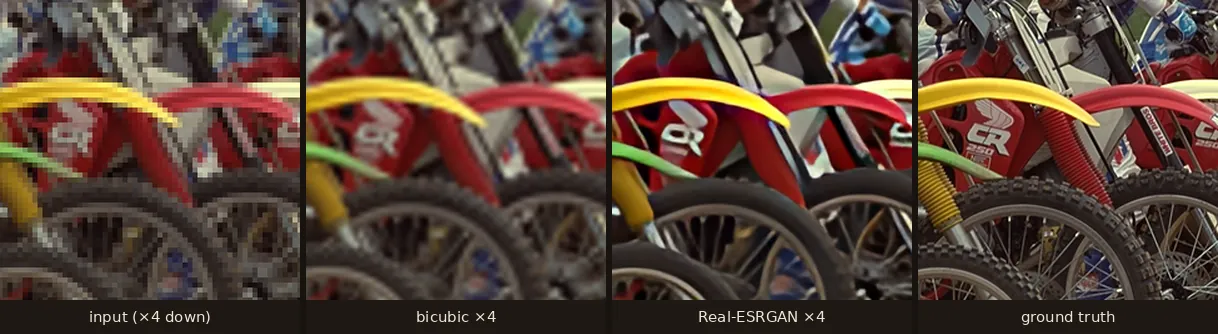
3 · El problema del grano de película, cuantificado
Los promedios esconden el hallazgo más útil. Divide el corpus y los deltas de PSNR por imagen (Real-ESRGAN − Lanczos-3) son claramente bimodales: en fotogramas modernos limpios el modelo está a menos de un decibelio (supera a Lanczos directamente en uno, +0.15 dB); en los cuatro escaneos históricos de película pierde catastróficamente: las medias del subconjunto son 28.75 frente a 32.12 dB:
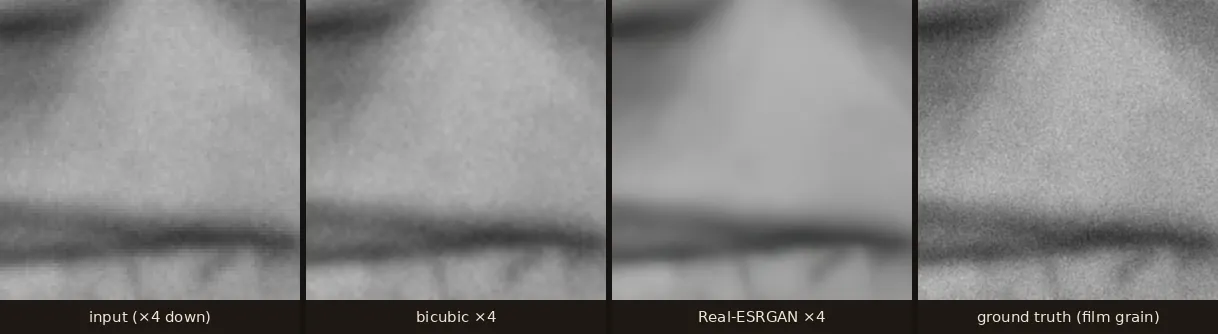
Bajo una lupa los números se vuelven obvios: el escaneo de referencia es un muro de grano honesto, y el modelo devuelve porcelana. En Madre migrante cae 1.71 dB y 0.064 de SSIM, y algunos espectadores seguirán prefiriendo la salida limpia. Las métricas no son gusto; son un contrato sobre qué gusto estás optimizando. Esta medición es la razón por la que la etapa de mejora omite las fotos ya cercanas a su objetivo de resolución (un escaneo de archivo de alta resolución conserva sus píxeles nativos y su grano), y por la que nuestro renderizado facial vuelve a mezclar el grano propio de la fotografía sobre las caras restauradas en lugar de entregar la porcelana del modelo.
4 · Limitaciones
- Sin métrica perceptual aprendida. LPIPS o DISTS afinarían el eje de percepción; Tenengrad es un sustituto honesto pero más simple. Los registros brutos están publicados para que cualquiera pueda volver a puntuar.
- Una sola degradación. La bicúbica ×4 es el protocolo estándar y el caso más amable; los escaneos reales añaden núcleos de desenfoque, JPEG y ruido (la nota facial usa la pila de corrupción completa).
- N = 28: de sobra para estos tamaños de efecto (el orden es estable bajo leave-one-out), poco para afirmaciones por subgrupos más allá de la división por grano.
5 · Conclusión
Medida como reconstrucción de señal, la superresolución con IA es un interpolador peor que Lanczos-3: 1.07 dB peor aquí, exactamente como predice el compromiso percepción–distorsión[3]. Medida como reconstrucción de una fotografía (estructura, energía de bordes y tus ojos) no hay comparación, en la otra dirección. La lectura práctica para tu caja de zapatos: para las fotos que van a ver personas, el modelo es la opción por defecto correcta; para los másteres de archivo, donde cada partícula de grano es evidencia, conserva también el escaneo en bruto. La herramienta de restauración está construida exactamente en torno a esa división.
Referencias
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Wang, Z., Bovik, A. C., Sheikh, H. R., & Simoncelli, E. P. (2004). Image Quality Assessment: From Error Visibility to Structural Similarity. IEEE Transactions on Image Processing, 13(4), 600–612. doi.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai