Por que rostos restaurados por IA parecem personagens de videogame
Modelos de restauração de rostos podem fazer um rosto de uma foto danificada parecer uma renderização de videogame antigo: pele de plástico, olhos pintados, um rosto nítido mas que não é bem a pessoa. Comparamos oito variantes de renderização em 11 fotografias de domínio público para isolar as causas: são três, são separáveis e nenhuma se resolve com um “modelo melhor”. Esta revisão acrescenta o que a bancada original não tinha: números. Medir de novo a renderização escolhida com um embedding de reconhecimento facial[4] confirma quantitativamente a seleção feita a olho (cada ajuste da renderização “natural” compra identidade mensurável, cortando pela metade o imposto de identidade da restauração), e uma varredura completa do controle de fidelidade mostra por que ele sai de fábrica em 0.7 mesmo com todas as curvas sendo monótonas rumo a 1.0.
Cada número desta nota foi medido no código do pipeline de produção: os mesmos modelos, a mesma matemática. Registros brutos por imagem: e2v2_face.json · e2_face.json.
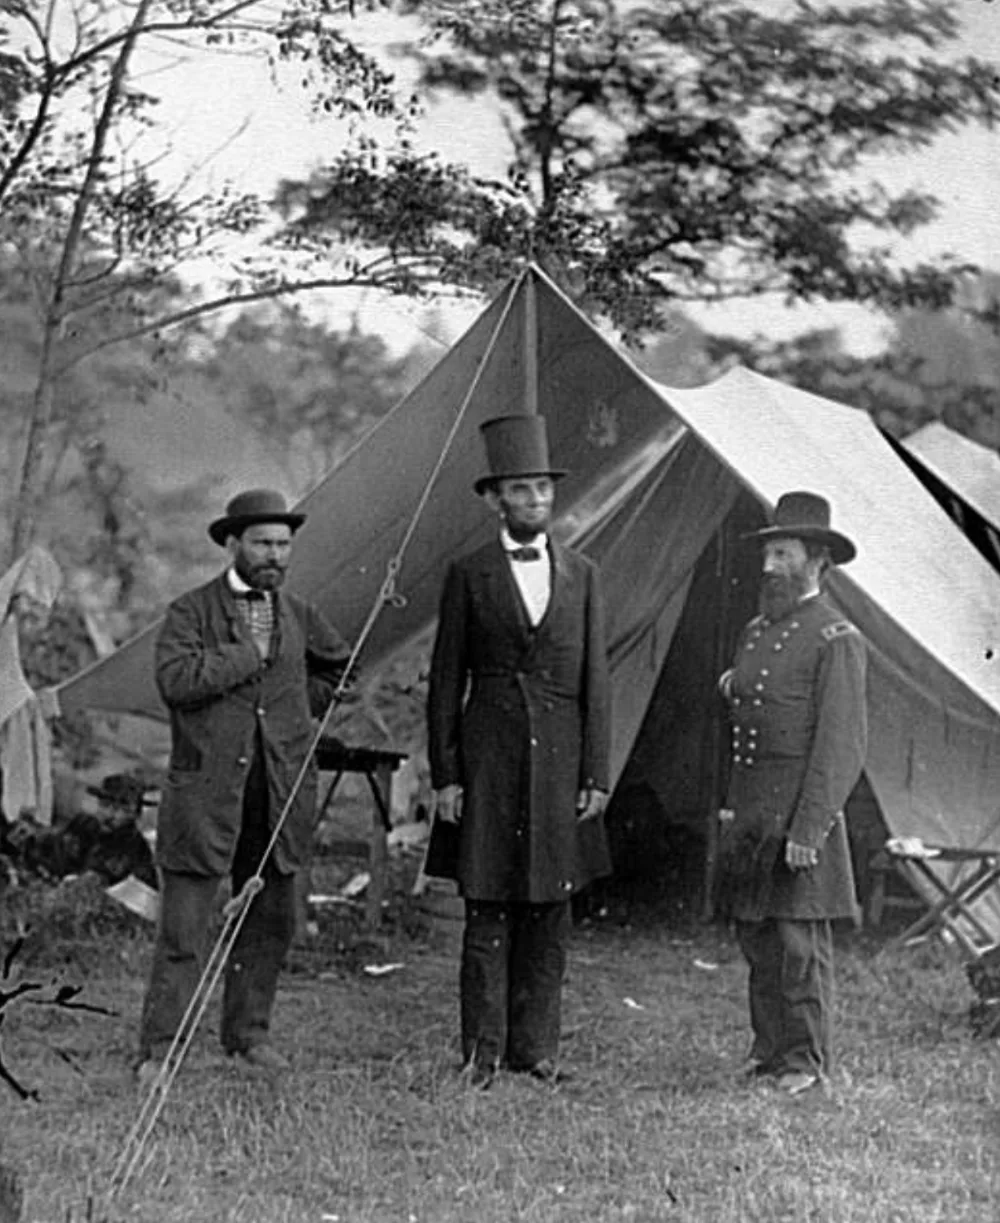 Antes
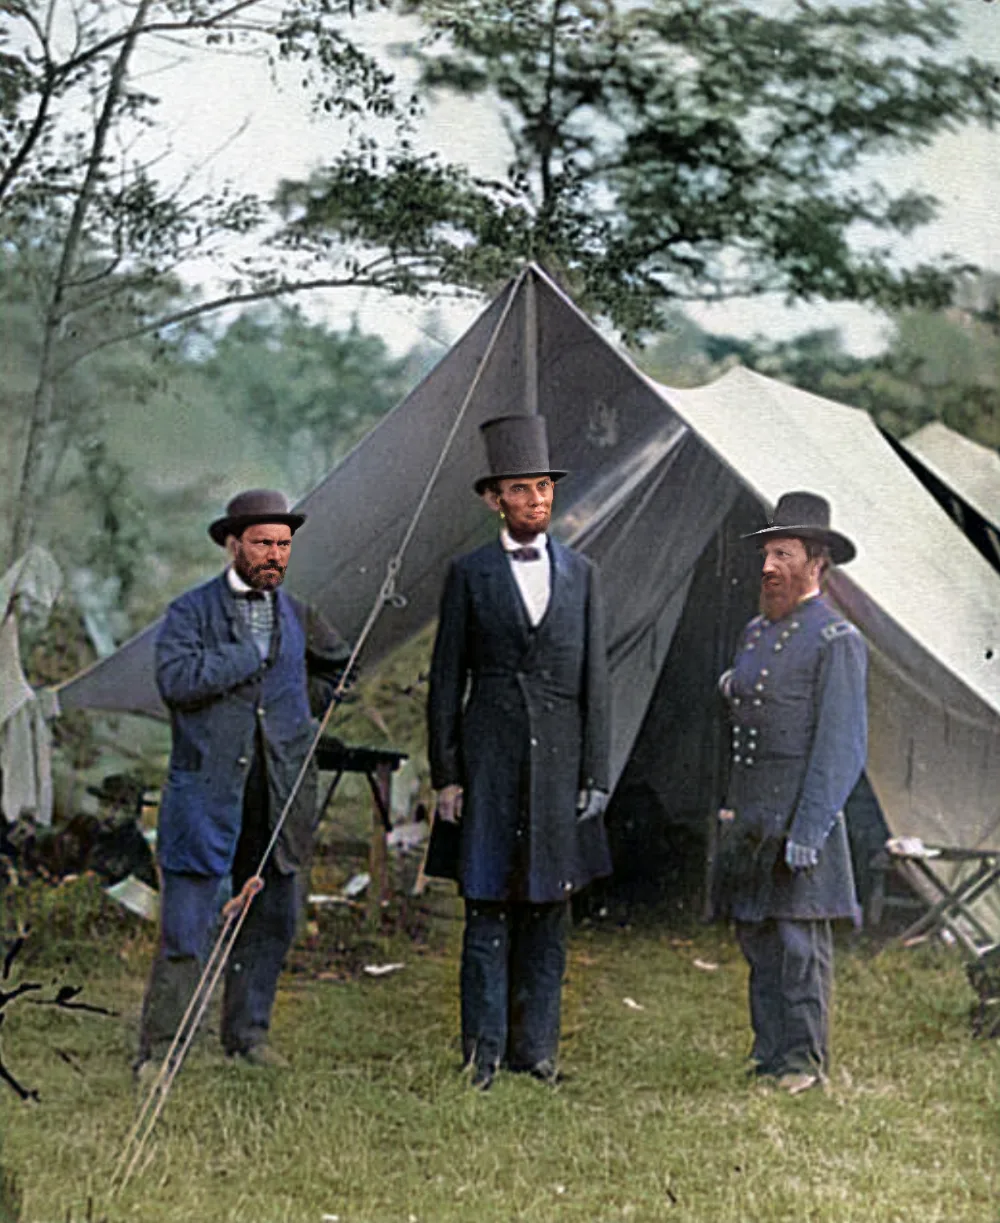 Depois
1 · As três causas
1. Substituição total. O pipeline padrão cola a saída do modelo sobre o rosto original com 100% de opacidade, então cada rosto restaurado é inteiramente desenhado pelo modelo. O grão da fotografia, a textura do papel e o caráter da lente terminam em uma fronteira oval invisível ao redor de cada rosto.
2. Desvio de cor. O modelo de rostos produz a própria cor, não a da foto. Medido na nossa bancada, ele inventou olhos azuis em um ambrótipo da década de 1850 e clareou o tom de pele em um retrato de estúdio do século XIX de uma pessoa negra, um modo de falha conhecido de modelos de rostos treinados em corpora fotográficos modernos, predominantemente de pele clara[2]. Qualquer pipeline que mantenha o croma do modelo herda seus vieses.
3. Rostos pequenos são alucinações. Um rosto que ocupa menos de cerca de 100 px chega a um modelo de rostos de 512 px como uma ampliação bilinear de 5–13×, um borrão. O modelo então inventa um rosto plausível em vez de recuperar o verdadeiro. Isso é um limite da física, não do modelo: um rosto de 40 px pode ficar suave-mas-humano, nunca nítido-e-fiel.
2 · Anatomia de um reparo de rosto
Para ver onde ficam os ajustes, acompanhe um rosto pelo pipeline. A detecção (SCRFD, com o crivo de plausibilidade) produz cinco pontos de referência. O alinhamento resolve a transformação de similaridade por mínimos quadrados (escala s, rotação θ, translação t) que mapeia os pontos detectados de olhos e boca pi sobre o modelo fixo FFHQ[5] qi:
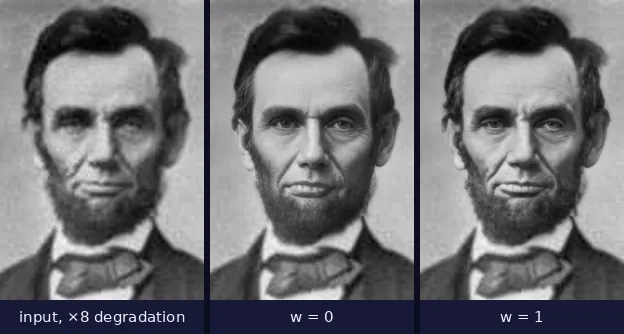
de modo que todo rosto entra na rede em 512×512 com olhos e boca em posição canônica. O modelo, CodeFormer por padrão[1], que restaura consultando rostos em um codebook aprendido em vez de regredir pixels, e expõe um peso de fidelidade w ∈ [0, 1] que dosa entre seu prior (0) e a sua entrada (1), produz um recorte restaurado. Então vem a parte de que esta nota trata: a colagem de volta. A receita clássica compõe esse recorte com opacidade total e nas cores do próprio modelo. A nossa o devolve ao lugar sob uma suavização radial m e compõe cada pixel como
com blend = 0.75, e faceL⊕photoab significando que o modelo contribui só com a luminância (L do Lab) enquanto a fotografia mantém o próprio croma, o espelho exato do nosso colorizador, que contribui só com o croma e mantém a luminância da foto. Rostos pequenos recebem uma passagem dedicada de super-resolução ×4 na sua área de origem antes da restauração, para que o modelo veja detalhe recuperado em vez de um borrão bilinear.
3 · A bancada visual que escolheu a variante H
Oito variantes, cada uma uma execução completa do pipeline sobre o corpus, variando o peso de fidelidade, a opacidade da colagem de volta, a fonte da cor e a SR de rostos pequenos. As saídas foram comparadas lado a lado com os originais em zoom de 100%:
| Variante | Peso | Colagem de volta | Fonte da cor | SR de rostos pequenos |
|---|---|---|---|---|
| A (a de então) | 0.70 | 100% | modelo | – |
| B | 0.90 | 100% | modelo | – |
| C | 0.70 | 70% | modelo | – |
| D | 0.70 | 100% | fotografia | – |
| E | 0.70 | 75% | fotografia | – |
| F | 0.85 | 75% | fotografia | – |
| G | 0.70 | 50% | fotografia | – |
| H (selecionada) | 0.70 | 75% | fotografia | sim |
A H entrou em produção como renderização padrão. A colagem de volta só de luminância acrescenta menos de meio segundo por foto; a passagem de rostos pequenos acrescenta um a dois segundos só por rosto elegível. A seção de limitações original admitia a fraqueza óbvia: a seleção foi por julgamento humano lado a lado em 35 rostos, não por uma métrica. Então construímos a bancada de métricas.
4 · Novo: a ablação, quantificada
Um número enquadra tudo: a própria entrada degradada pontua 0.950 de identidade contra o original. O ArcFace foi treinado sob aumento de dados pesado, então enxerga através de borrão e ruído; a restauração, portanto, não ganha crédito por ser nítida; ela só é debitada quando muda quem está na foto. Todo renderizador paga uma parte desse imposto de identidade. A questão é quanto:
| Renderização (todas em w = 0.7) | PSNR (dB) | id ArcFace | imposto de identidade | razão Tenengrad |
|---|---|---|---|---|
| Entrada degradada (linha de base) | 27.32 | 0.950 | – | 0.217 |
| Classic v2 (100% paste, model colour) | 26.68 | 0.868 | −0.082 | 0.373 |
| + luma-only (photo keeps its chroma) | 26.72 | 0.882 | −0.068 | 0.376 |
| + 75% blend (grain shows through) | 27.06 | 0.901 | −0.049 | 0.304 |
| Natural (shipped: both + small-face SR) | 27.09 | 0.909 | −0.041 | 0.307 |
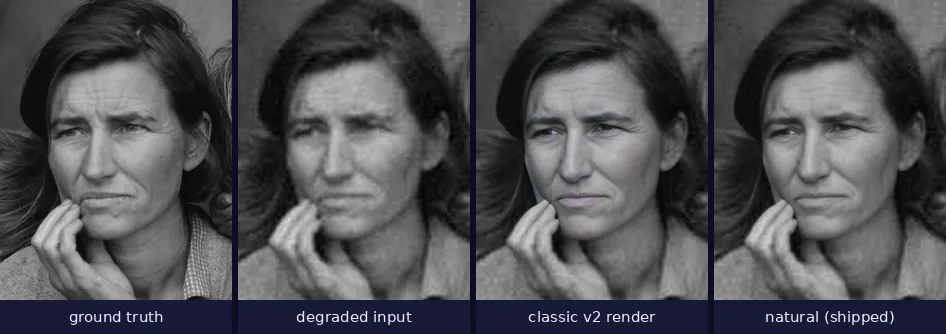
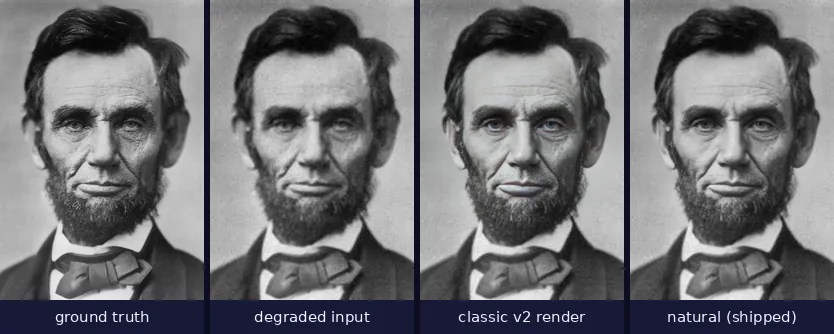
A bancada de métricas concorda com os olhos, ajuste por ajuste. Manter o croma da fotografia compra +0.014 de identidade (o desvio de cor era real, e mensurável). A mescla de 75% compra outros +0.019 e a maior parte do PSNR: deixar um quarto do rosto verdadeiro transparecer vale quase tanto quanto todo o ajuste de fidelidade do modelo de rostos. Juntos, eles reduzem o imposto de identidade pela metade, de −0.082 para −0.041, mantendo ainda cerca de 1.4× a nitidez da entrada. O único custo honesto: a renderização clássica é “mais nítida” pelo Tenengrad (0.373 vs 0.307), nitidez que ela gasta em parte em textura que não é da fotografia. Esse é o compromisso percepção–distorção[6] deslocado para a renderização, e nós o gastamos em identidade.
5 · O controle de fidelidade, varrido de ponta a ponta
O peso w do CodeFormer dosa entre o prior do codebook (0) e a deferência à sua entrada (1)[1]. Nós o varremos em onze passos sob o renderizador natural:
Entramos esperando uma curva de compromisso com um ótimo interior que justificasse 0.7 como “o joelho”. Os dados recusaram: nos números, w = 1.0 domina, em toda severidade:
Então por que sair de fábrica em 0.7 e não em 1.0? Porque as métricas são necessárias, não suficientes. O ArcFace mede quem; é quase cego a idade e textura; o mesmo treinamento que o torna robusto ao borrão o torna tolerante à suavização. A observação original da bancada se sustenta pela própria evidência: no 0.5 habitual do modelo, os pés de galinha visivelmente amaciam em Migrant Mother: Florence Owens Thompson tinha 32 anos e carregava a Depressão no rosto, e o prior preferiria que não. Em w = 1.0 o codebook se curva tanto a uma entrada arruinada que lixo de compressão começa a sobreviver. 0.7 mantém quase todo o valor da métrica (0.909 vs 0.932) enquanto as imagens mantêm sua idade. E o painel s8 abaixo é o argumento para nunca deixar w perto de 0 em fotos históricas danificadas:
6 · Os outros modelos, mesmo renderizador
| Modelo de rostos | PSNR (dB) | id ArcFace | razão Tenengrad | ms / rosto* |
|---|---|---|---|---|
| CodeFormer (w = 0.7, default) | 27.09 | 0.909 | 0.307 | 7200 |
| GFPGAN 1.4 | 27.13 | 0.910 | 0.328 | 6046 |
| GPEN-BFR-256 | 26.68 | 0.927 | 0.322 | 2633 |
*Mediana do tempo de relógio da passagem completa (detecção incluída) na máquina de bancada de 2 vCPUs. Sob o renderizador natural, os três modelos[1][2][3] convergem para dentro de 0.02 de identidade uns dos outros: o renderizador, não o modelo, é agora o termo dominante, o que é por si só um achado: o aspecto de “videogame” nunca foi realmente uma questão de qual rede você roda. O CodeFormer continua como padrão pela robustez em danos severos e pelo controle a que esta nota acabou de dedicar duas seções; o GPEN continua sendo a escolha de velocidade, a 2.6 s por rosto.
7 · Limitações
- A bancada visual tem 35 rostos; a bancada de métricas tem 4 retratos × 120 execuções. As formas monótonas se mantiveram em cada retrato individualmente; essa é a afirmação em que nos apoiamos; os valores absolutos vão variar com o sujeito e a digitalização.
- O ArcFace é um único árbitro, o padrão, com a ressalva da tolerância ao borrão que exploramos como linha de base. Um estudo perceptual humano sobre milhares de rostos é o instrumento que falta, e a observação sobre as linhas de idade se apoia em olhos, não em embeddings.
- Degradação sintética. Danos reais de caixa de sapatos acrescentam riscos e espelhamento de prata que a pilha de corrupção não modela; a etapa de danos trata deles separadamente.
- O limite dos rostos pequenos se mantém: abaixo de cerca de 40 px de rosto, nenhum ajuste produz um rosto nítido e fiel, e a saída honesta é um rosto suave.
Referências
- Zhou, S., Chan, K. C. K., Li, C., & Loy, C. C. (2022). Towards Robust Blind Face Restoration with Codebook Lookup Transformer. NeurIPS 35. arXiv:2206.11253. arxiv.org
- Wang, X., Li, Y., Zhang, H., & Shan, Y. (2021). Towards Real-World Blind Face Restoration with Generative Facial Prior. CVPR. arXiv:2101.04061. arxiv.org
- Yang, T., Ren, P., Xie, X., & Zhang, L. (2021). GAN Prior Embedded Network for Blind Face Restoration in the Wild. CVPR. arXiv:2105.06070. arxiv.org
- Deng, J., Guo, J., Xue, N., & Zafeiriou, S. (2019). ArcFace: Additive Angular Margin Loss for Deep Face Recognition. CVPR. arXiv:1801.07698. arxiv.org
- Karras, T., Laine, S., & Aila, T. (2019). A Style-Based Generator Architecture for Generative Adversarial Networks (the FFHQ alignment template). CVPR. arXiv:1812.04948. arxiv.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- FaceFusion (open-source face processing platform): the reference implementation our SCRFD decode and model preprocessing are ported from, 1:1. github.com
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- Gardner, A. (1863). Abraham Lincoln, portrait O-77. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai