Pourquoi les visages restaurés par IA ressemblent à des personnages de jeu vidéo
Les modèles de restauration de visages peuvent donner à un visage tiré d'une photo abîmée l'allure d'un rendu de vieux jeu vidéo : peau plastique, yeux peints, un visage net mais pas tout à fait la personne. Nous avons comparé huit variantes de rendu sur 11 photographies du domaine public pour isoler les causes : il y en a trois, elles sont séparables, et aucune n'est corrigée par un « meilleur modèle ». Cette révision ajoute ce qui manquait au banc d'origine : des chiffres. Remesurer le rendu retenu avec un plongement de reconnaissance faciale[4] confirme quantitativement la sélection à l'œil (chaque réglage du rendu « naturel » achète une identité mesurable, divisant par deux la taxe d'identité de la restauration), et un balayage complet du curseur de fidélité montre pourquoi il est livré à 0,7 alors que chaque courbe est monotone vers 1,0.
Chaque chiffre de cette note a été mesuré sur le code du pipeline de production : mêmes modèles, mêmes calculs. Données brutes par image : e2v2_face.json · e2_face.json.
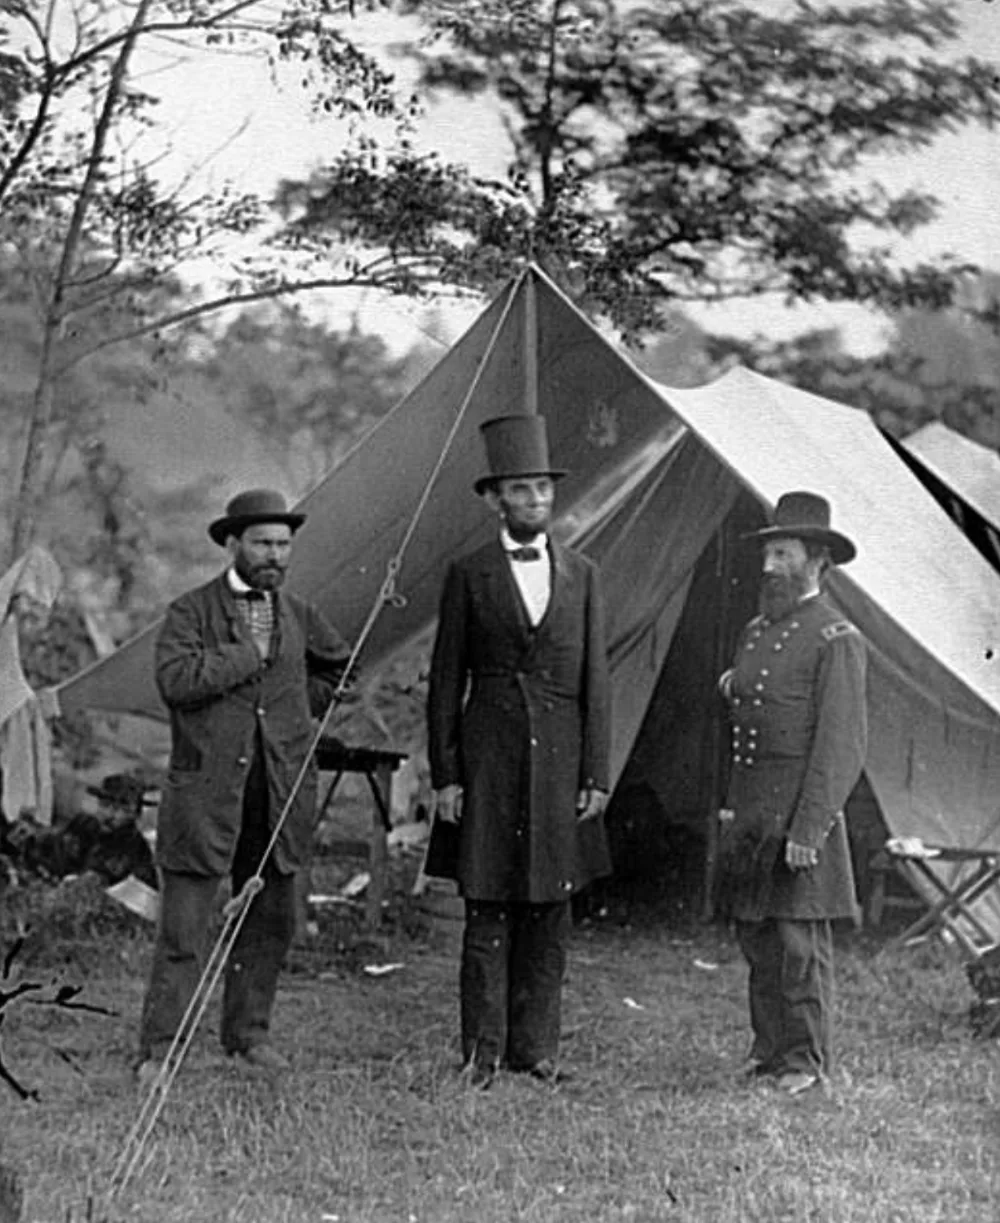 Avant
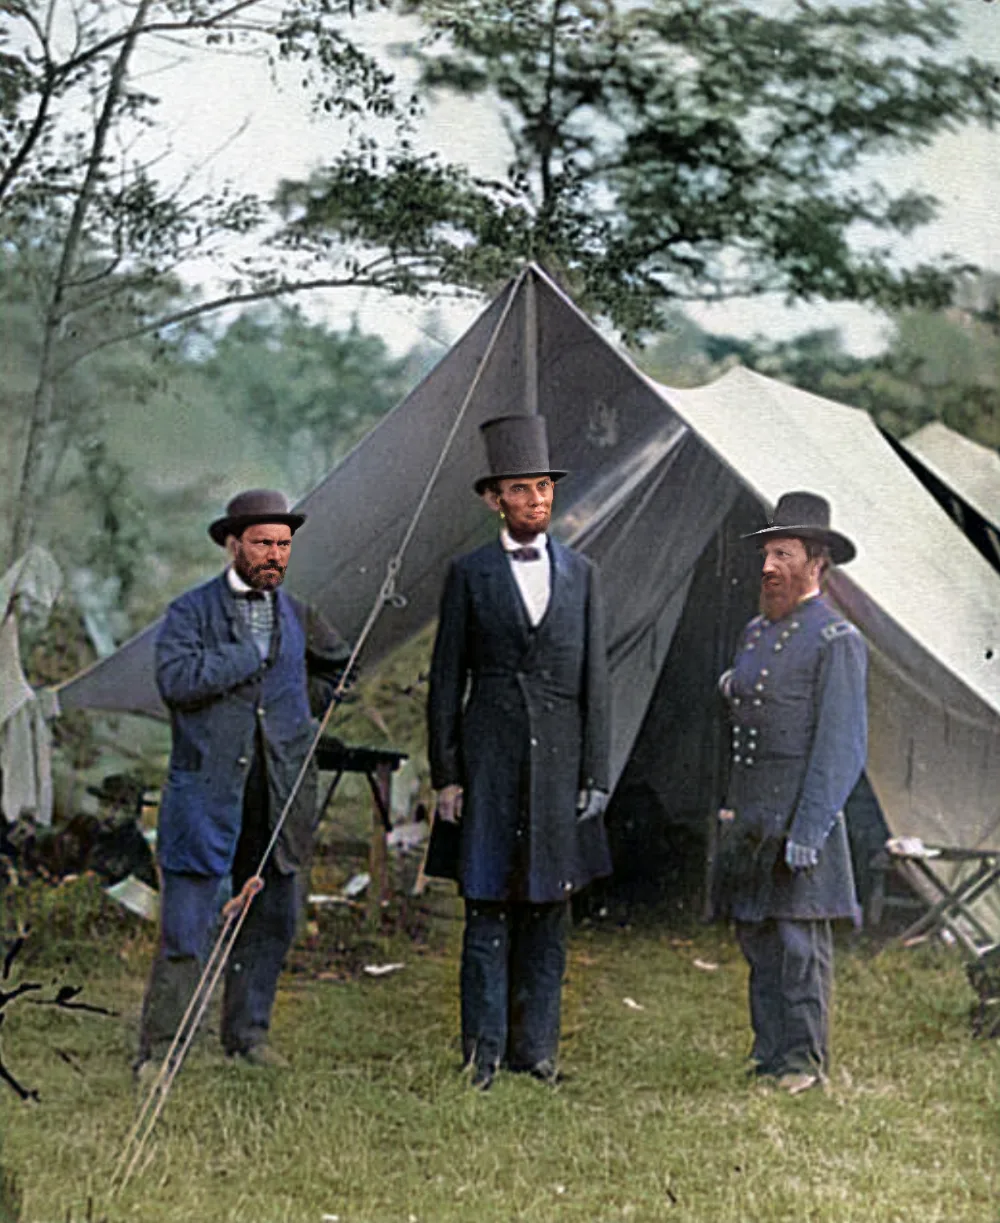 Après
1 · Les trois causes
1. Le remplacement total. Le pipeline standard colle la sortie du modèle par-dessus le visage d'origine à 100 % d'opacité, si bien que chaque visage restauré est entièrement dessiné par le modèle. Le grain de la photographie, la texture du papier et le caractère de l'objectif s'arrêtent à une frontière ovale invisible autour de chaque visage.
2. La dérive de couleur. Le modèle de visages produit sa propre couleur, pas celle de la photo. Mesuré sur notre banc, il a inventé des yeux bleus sur un ambrotype des années 1850 et éclairci la carnation d'un portrait de studio du XIXe siècle d'un sujet noir, un mode d'échec connu des modèles de visages entraînés sur des corpus modernes, majoritairement à peau claire[2]. Tout pipeline qui conserve la chrominance du modèle hérite de ses biais.
3. Les petits visages sont des hallucinations. Un visage qui occupe moins d'environ 100 px arrive dans un modèle de visages de 512 px sous la forme d'un agrandissement bilinéaire de 5 à 13×, une bouillie. Le modèle invente alors un visage plausible au lieu de récupérer le vrai. C'est une limite physique, pas une limite du modèle : un visage de 40 px peut être rendu doux-mais-humain, jamais net-et-fidèle.
2 · Anatomie d'une réparation de visage
Pour voir où se trouvent les réglages, suivons un visage à travers le pipeline. La détection (SCRFD, avec le filtre de plausibilité) fournit cinq points de repère. L'alignement résout la transformation de similitude aux moindres carrés (échelle s, rotation θ, translation t) qui envoie les points des yeux et de la bouche détectés pi sur le gabarit FFHQ fixe[5] qi :
de sorte que chaque visage entre dans le réseau en 512×512 avec les yeux et la bouche en position canonique. Le modèle, CodeFormer par défaut[1], qui restaure en cherchant les visages dans un codebook appris plutôt qu'en régressant des pixels, et expose un poids de fidélité w ∈ [0, 1] qui arbitre entre son a priori (0) et ton entrée (1), produit un recadrage restauré. Vient ensuite la partie dont traite cette note : la réinsertion. La recette classique composite ce recadrage à pleine opacité, dans les couleurs propres du modèle. La nôtre le déforme vers sa place d'origine sous un dégradé radial m et composite chaque pixel comme
avec blend = 0,75, et faceL⊕photoab signifiant que le modèle n'apporte que la luminance (le L de Lab) tandis que la photographie garde sa propre chrominance, l'exact miroir de notre modèle de colorisation, qui n'apporte que la chrominance et garde la luminance de la photo. Les petits visages reçoivent une passe de super-résolution ×4 dédiée sur leur empreinte source avant restauration, pour que le modèle voie des détails récupérés au lieu d'une bouillie bilinéaire.
3 · Le banc visuel qui a retenu la variante H
Huit variantes, chacune une exécution complète du pipeline sur le corpus, en faisant varier le poids de fidélité, l'opacité de la réinsertion, la source de couleur et la SR des petits visages. Les sorties ont été comparées côte à côte aux originaux à 100 % de zoom :
| Variante | Poids | Réinsertion | Source de couleur | SR petits visages |
|---|---|---|---|---|
| A (alors en production) | 0,70 | 100 % | modèle | – |
| B | 0,90 | 100 % | modèle | – |
| C | 0,70 | 70 % | modèle | – |
| D | 0,70 | 100 % | photographie | – |
| E | 0,70 | 75 % | photographie | – |
| F | 0,85 | 75 % | photographie | – |
| G | 0,70 | 50 % | photographie | – |
| H (retenue) | 0,70 | 75 % | photographie | oui |
H est devenue le rendu par défaut. La réinsertion en luminance seule ajoute moins d'une demi-seconde par photo ; la passe petits visages ajoute une à deux secondes par visage concerné seulement. La section sur les limites d'origine admettait la faiblesse évidente : la sélection reposait sur un jugement humain côte à côte sur 35 visages, pas sur une métrique. Alors nous avons construit le banc métrique.
4 · Nouveau : l'ablation, quantifiée
Un chiffre cadre tout le reste : l'entrée dégradée elle-même obtient 0,950 d'identité contre l'original. ArcFace a été entraîné sous forte augmentation, donc il voit à travers le flou et le bruit ; la restauration n'est donc pas créditée d'être nette ; elle n'est débitée que lorsqu'elle change qui est sur la photo. Chaque moteur de rendu paie une part de cette taxe d'identité. La question est : combien ?
| Rendu (tous à w = 0,7) | PSNR (dB) | id ArcFace | taxe d'identité | ratio Tenengrad |
|---|---|---|---|---|
| Entrée dégradée (référence) | 27.32 | 0.950 | – | 0.217 |
| Classic v2 (100% paste, model colour) | 26.68 | 0.868 | −0.082 | 0.373 |
| + luma-only (photo keeps its chroma) | 26.72 | 0.882 | −0.068 | 0.376 |
| + 75% blend (grain shows through) | 27.06 | 0.901 | −0.049 | 0.304 |
| Natural (shipped: both + small-face SR) | 27.09 | 0.909 | −0.041 | 0.307 |
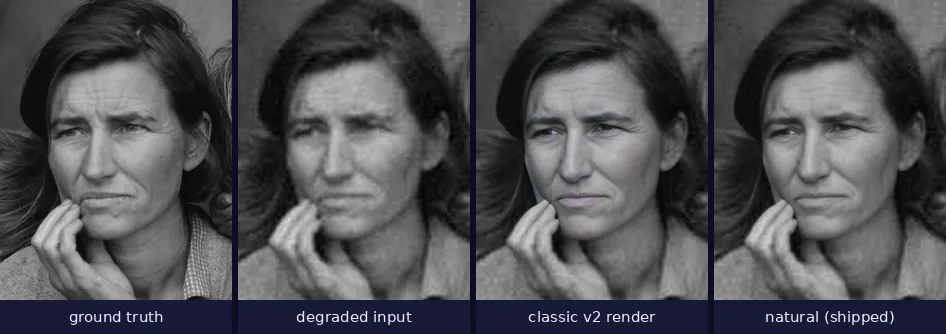
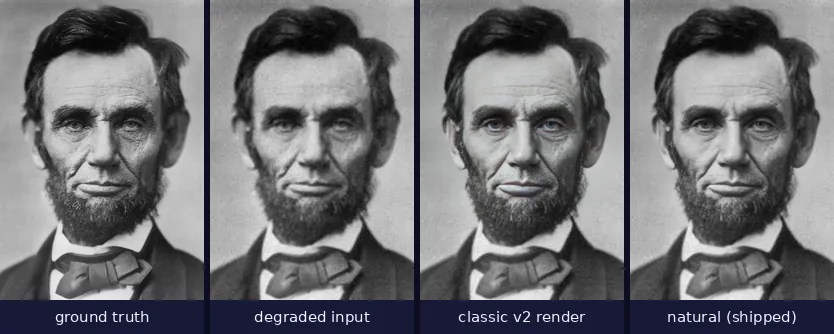
Le banc métrique est d'accord avec les yeux, réglage par réglage. Garder la chrominance de la photographie rapporte +0,014 d'identité (la dérive de couleur était réelle, et mesurable). La fusion à 75 % rapporte encore +0,019 et l'essentiel du PSNR : laisser transparaître un quart du vrai visage vaut presque autant que tout le réglage de fidélité du modèle de visages. Ensemble, ils divisent la taxe d'identité par deux, de −0,082 à −0,041, tout en restant à environ 1,4× la netteté de l'entrée. Le seul coût honnête : le rendu classique est « plus net » selon Tenengrad (0,373 contre 0,307), une netteté qu'il dépense en partie en texture qui n'est pas celle de la photographie. C'est le compromis perception-distorsion[6] déplacé dans le rendu, et nous le dépensons en identité.
5 · Le curseur de fidélité, balayé de bout en bout
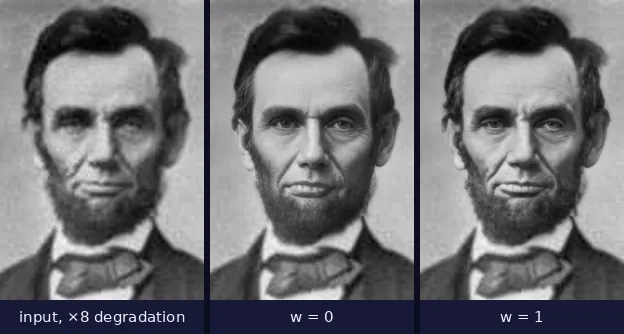
Le poids w de CodeFormer arbitre entre l'a priori du codebook (0) et la déférence envers ton entrée (1)[1]. Nous l'avons balayé en onze pas sous le rendu naturel :
Nous nous attendions à une courbe de compromis avec un optimum intérieur qui justifierait 0,7 comme « le coude ». Les données ont refusé : sur les chiffres, w = 1,0 domine, à chaque sévérité :
Alors pourquoi livrer 0,7 plutôt que 1,0 ? Parce que les métriques sont nécessaires, pas suffisantes. ArcFace mesure qui ; il est presque aveugle à l'âge et à la texture ; le même entraînement qui le rend robuste au flou le rend indulgent envers le lissage. L'observation d'origine du banc tient sur ses propres preuves : au 0,5 habituel du modèle, les pattes-d'oie s'adoucissent visiblement sur Migrant Mother : Florence Owens Thompson avait 32 ans et portait la Grande Dépression sur son visage, et l'a priori préférerait que non. À w = 1,0, le codebook s'en remet tellement à une entrée ruinée que des déchets de compression commencent à survivre. 0,7 conserve presque toute la valeur métrique (0,909 contre 0,932) tandis que les images gardent leur âge. Et le panneau s8 ci-dessous est l'argument pour ne jamais laisser w approcher 0 sur des photos patrimoniales abîmées :
6 · Les autres modèles, même rendu
| Modèle de visages | PSNR (dB) | id ArcFace | ratio Tenengrad | ms / visage* |
|---|---|---|---|---|
| CodeFormer (w = 0.7, default) | 27.09 | 0.909 | 0.307 | 7200 |
| GFPGAN 1.4 | 27.13 | 0.910 | 0.328 | 6046 |
| GPEN-BFR-256 | 26.68 | 0.927 | 0.322 | 2633 |
*Temps écoulé médian d'une passe complète (détection comprise) sur la machine de test à 2 vCPU. Sous le rendu naturel, les trois modèles[1][2][3] convergent à 0,02 d'identité les uns des autres : le rendu, pas le modèle, est désormais le terme dominant, ce qui est en soi un résultat : l'aspect « jeu vidéo » n'a jamais vraiment dépendu du réseau utilisé. CodeFormer reste le défaut pour sa robustesse sur les dommages sévères et pour le curseur auquel cette note vient de consacrer deux sections ; GPEN reste le choix de la vitesse à 2,6 s par visage.
7 · Limites
- Le banc visuel compte 35 visages ; le banc métrique 4 portraits × 120 exécutions. Les formes monotones ont tenu sur chaque portrait individuellement ; c'est l'affirmation sur laquelle nous nous appuyons ; les valeurs absolues varieront avec le sujet et le scan.
- ArcFace est un seul arbitre, l'arbitre standard, avec la tolérance au flou que nous exploitons comme référence. Une étude perceptuelle humaine sur des milliers de visages est l'instrument manquant, et l'observation sur les rides repose sur les yeux, pas sur des plongements.
- Dégradation synthétique. Les vrais dommages de boîte à chaussures ajoutent rayures et miroir d'argent que la pile de corruption ne modélise pas ; l'étape de réparation des dommages les traite séparément.
- La limite des petits visages tient : sous environ 40 px de visage, aucun réglage ne produit un visage net et fidèle, et la sortie honnête est un visage doux.
Références
- Zhou, S., Chan, K. C. K., Li, C., & Loy, C. C. (2022). Towards Robust Blind Face Restoration with Codebook Lookup Transformer. NeurIPS 35. arXiv:2206.11253. arxiv.org
- Wang, X., Li, Y., Zhang, H., & Shan, Y. (2021). Towards Real-World Blind Face Restoration with Generative Facial Prior. CVPR. arXiv:2101.04061. arxiv.org
- Yang, T., Ren, P., Xie, X., & Zhang, L. (2021). GAN Prior Embedded Network for Blind Face Restoration in the Wild. CVPR. arXiv:2105.06070. arxiv.org
- Deng, J., Guo, J., Xue, N., & Zafeiriou, S. (2019). ArcFace: Additive Angular Margin Loss for Deep Face Recognition. CVPR. arXiv:1801.07698. arxiv.org
- Karras, T., Laine, S., & Aila, T. (2019). A Style-Based Generator Architecture for Generative Adversarial Networks (the FFHQ alignment template). CVPR. arXiv:1812.04948. arxiv.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- FaceFusion (open-source face processing platform): the reference implementation our SCRFD decode and model preprocessing are ported from, 1:1. github.com
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- Gardner, A. (1863). Abraham Lincoln, portrait O-77. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai