Agrandissement par IA vs bicubique : un banc d'essai de 28 images
Tous les outils photo promettent désormais d'« améliorer ». Le nôtre fait tourner Real-ESRGAN[1], alors nous devions une réponse à une question inconfortable : quand on mesure comme la littérature du traitement d'images mesure, l'IA bat-elle vraiment la simple interpolation bicubique ? Le résultat est le genre de réponse le plus intéressant (non, et aussi résolument oui), et la séparation entre ces deux réponses a un nom dans la littérature : le compromis perception-distorsion[3]. Cette note présente le banc d'essai complet, y compris le cas où l'IA perd lourdement (le grain argentique), et pourquoi nous livrons quand même le modèle qui perd le banc classique.
Chaque chiffre de cette note a été mesuré sur le code du pipeline de production : mêmes modèles, mêmes calculs. Données brutes par image : e1_sr.json.
1 · Méthode
Le corpus est la Kodak Lossless True Color Suite de 24 images[4] (le jeu de référence en 768×512 sur lequel la littérature de la compression et de la super-résolution s'appuie depuis trois décennies), plus quatre recadrages de 768×512 tirés de scans haute résolution de photographies historiques, dont Migrant Mother de Dorothea Lange (1936)[5], parce que ce site existe pour les vieilles photos et que les vieilles photos ont du grain argentique. Cette distinction décide de la section 3.
Nous notons trois choses. La fidélité, comme rapport signal sur bruit de crête sur le RVB :
la similarité structurelle (SSIM[2], sur le luma, la fenêtre gaussienne standard de 11×11, σ = 1,5, K₁ = 0,01, K₂ = 0,03) :
et la netteté comme mesure de Tenengrad (magnitude quadratique moyenne du gradient de Sobel), rapportée comme un ratio de restauration, Tenengrad(sortie) ÷ Tenengrad(vérité terrain). Un ratio de 1,0 signifierait que la reconstruction porte autant d'énergie de contours que la photographie d'origine.
2 · Résultats : le compromis, en direct
Sur la métrique que tout le monde rapporte, l'échelle classique se comporte exactement comme la théorie de l'échantillonnage le prédit (chaque meilleur noyau achète une fraction de décibel), et Real-ESRGAN arrive avant-dernier :
| Méthode | PSNR (dB) | σ | SSIM | ratio Tenengrad | ms / image* |
|---|---|---|---|---|---|
| Plus proche voisin | 25.42 | ±3.42 | 0.673 | 0.382 | 8 |
| Bilinéaire | 25.88 | ±3.62 | 0.687 | 0.152 | 236 |
| Bicubique (Catmull-Rom) | 26.29 | ±3.68 | 0.705 | 0.196 | 343 |
| Lanczos-3 | 26.45 | ±3.71 | 0.711 | 0.216 | 876 |
| Real-ESRGAN ×4 (le nôtre) | 25.38 | ±3.16 | 0.711 | 0.676 | 462 |
*Entrée de 192×128, matériel de classe conteneur à 2 vCPU ; les ratios se transposent, les millisecondes non. Si le PSNR était toute l'histoire, nous livrerions Lanczos-3 et supprimerions 4,9 MB de réseau de neurones. Mais place chaque méthode sur l'axe de fidélité contre l'axe de netteté et le plateau se scinde en deux espèces :
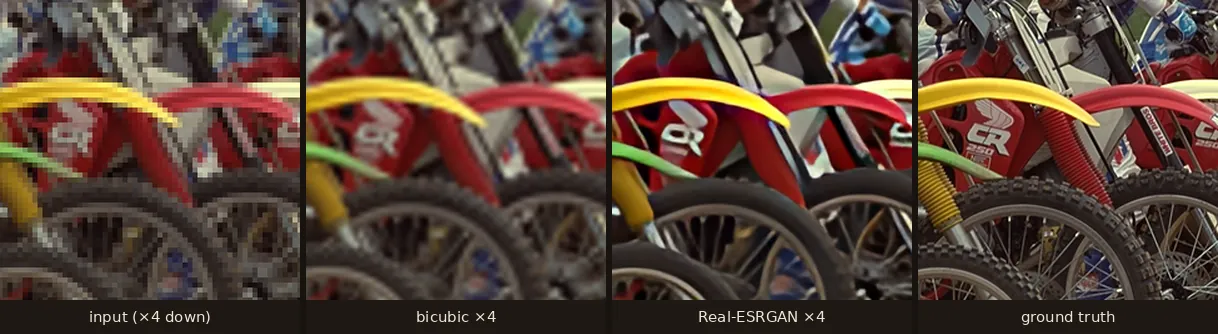
Le SSIM (conçu pour suivre la structure perçue plutôt que l'erreur brute[2]) coupe la poire en deux et se range, de peu, du côté du modèle : meilleure moyenne du plateau dans l'ensemble, et un plus net 0,704 contre 0,694 sur le sous-ensemble Kodak où la texture fine domine. Pourquoi l'interpolation ne peut-elle pas rivaliser en netteté ? Parce que tout noyau classique est un opérateur linéaire et invariant par translation : il ne peut que redistribuer les fréquences qui ont survécu au sous-échantillonnage, jamais créer celles qui n'ont pas survécu. La limite de Nyquist n'est pas une suggestion. Un a priori GAN contourne la limite en changeant la question : de « quel signal a produit ces échantillons ? » (sans réponse) à « de toutes les images naturelles qui se sous-échantillonneraient en ceci, laquelle est la plus plausible ? »[1] C'est aussi exactement là que vit son risque : plausible n'est pas vrai.
3 · Le problème du grain argentique, quantifié
Les moyennes cachent le résultat le plus utile. Scinde le corpus et les deltas de PSNR par image (Real-ESRGAN − Lanczos-3) sont nettement bimodaux : sur les images modernes propres, le modèle est à moins d'un décibel (il bat Lanczos franchement sur l'une d'elles, +0,15 dB) ; sur les quatre scans argentiques historiques, il perd catastrophiquement : les moyennes du sous-ensemble sont de 28,75 contre 32,12 dB :
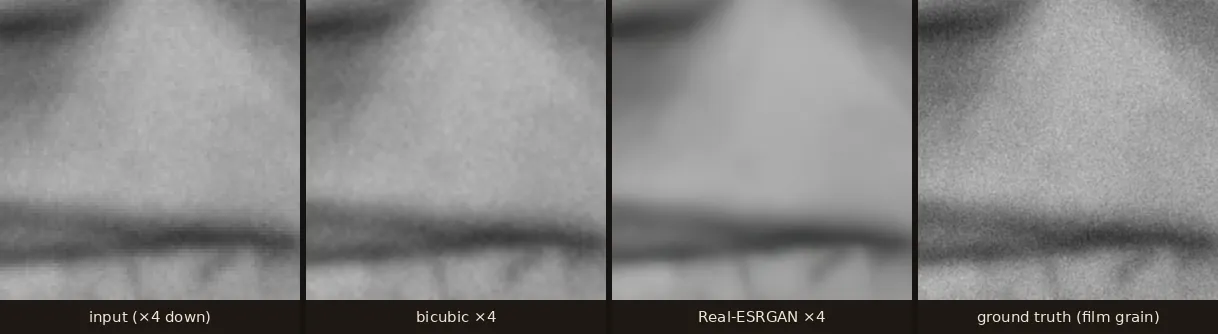
À la loupe, les chiffres deviennent évidents : le scan de vérité terrain est un mur d'honnête grain, et le modèle renvoie de la porcelaine. Sur Migrant Mother, il perd 1,71 dB et 0,064 de SSIM, et certains spectateurs préféreront quand même la sortie propre. Les métriques ne sont pas le goût ; elles sont un contrat sur quel goût on optimise. Cette mesure est la raison pour laquelle l'étape d'amélioration saute les photos déjà proches de sa cible de résolution (un scan d'archive haute résolution garde ses pixels natifs et son grain), et pour laquelle notre rendu des visages refond le grain propre de la photographie par-dessus les visages restaurés au lieu de livrer la porcelaine du modèle.
4 · Limites
- Pas de métrique perceptuelle apprise. LPIPS ou DISTS affineraient l'axe de la perception ; Tenengrad est un substitut honnête mais plus simple. Les données brutes sont publiées pour que chacun puisse renoter.
- Une seule dégradation. Le bicubique ×4 est le protocole standard et le cas le plus clément ; les vrais scans ajoutent des noyaux de flou, du JPEG et du bruit (la note sur les visages utilise la pile de corruption complète).
- N = 28 : largement assez pour ces tailles d'effet (l'ordre est stable en validation croisée leave-one-out), peu pour des affirmations par sous-groupe au-delà de la scission grain.
5 · Conclusion
Mesurée comme reconstruction de signal, la super-résolution par IA est un moins bon interpolateur que Lanczos-3 : 1,07 dB de moins ici, exactement comme le compromis perception-distorsion le prédit[3]. Mesurée comme reconstruction de photographie (structure, énergie de contours, et tes yeux), ce n'est pas serré, dans l'autre sens. La lecture pratique pour ta boîte à chaussures : pour les photos qui seront regardées par des gens, le modèle est le bon défaut ; pour les masters d'archive où chaque particule de grain est une preuve, garde aussi le scan brut. L'outil de restauration est construit exactement autour de cette scission.
Références
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Wang, Z., Bovik, A. C., Sheikh, H. R., & Simoncelli, E. P. (2004). Image Quality Assessment: From Error Visibility to Structural Similarity. IEEE Transactions on Image Processing, 13(4), 600–612. doi.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai