Ampliação por IA vs bicúbica: um benchmark de 28 imagens
Toda ferramenta de fotos agora promete “aprimorar”. A nossa roda o Real-ESRGAN[1], então devíamos uma resposta a uma pergunta desconfortável: quando você mede do jeito que a literatura de processamento de imagens mede, a IA realmente supera a simples interpolação bicúbica? O resultado é o tipo mais interessante de resposta (não, e também enfaticamente sim), e a divisão entre essas duas respostas tem nome na literatura: o compromisso percepção–distorção[3]. Esta nota mostra o benchmark completo, incluindo o caso em que a IA perde feio (grão de filme), e por que colocamos em produção o modelo que perde o benchmark clássico mesmo assim.
Cada número desta nota foi medido no código do pipeline de produção: os mesmos modelos, a mesma matemática. Registros brutos por imagem: e1_sr.json.
1 · Método
O corpus é o Kodak Lossless True Color Suite de 24 imagens[4] (o conjunto de referência de 768×512 em que a literatura de compressão e super-resolução se apoia há três décadas), mais quatro recortes de 768×512 de digitalizações em alta resolução de fotografias históricas, incluindo Migrant Mother, de Dorothea Lange, de 1936[5], porque este site existe para fotos antigas e fotos antigas têm grão de filme. Essa distinção decide a Seção 3.
Pontuamos três coisas. Fidelidade, como relação sinal-ruído de pico sobre RGB:
similaridade estrutural (SSIM[2], luma, a janela gaussiana padrão de 11×11, σ = 1.5, K₁ = 0.01, K₂ = 0.03):
e nitidez como a medida de Tenengrad (magnitude quadrática média do gradiente de Sobel), relatada como uma razão de restauração, Tenengrad(saída) ÷ Tenengrad(ground truth). Uma razão de 1.0 significaria que a reconstrução carrega tanta energia de bordas quanto a fotografia original.
2 · Resultados: o compromisso, ao vivo
Na métrica que todo mundo relata, a escada clássica se comporta exatamente como a teoria da amostragem prevê (cada kernel melhor compra uma fração de decibel), e o Real-ESRGAN chega em penúltimo:
| Método | PSNR (dB) | σ | SSIM | razão Tenengrad | ms / imagem* |
|---|---|---|---|---|---|
| Vizinho mais próximo | 25.42 | ±3.42 | 0.673 | 0.382 | 8 |
| Bilinear | 25.88 | ±3.62 | 0.687 | 0.152 | 236 |
| Bicúbico (Catmull-Rom) | 26.29 | ±3.68 | 0.705 | 0.196 | 343 |
| Lanczos-3 | 26.45 | ±3.71 | 0.711 | 0.216 | 876 |
| Real-ESRGAN ×4 (o nosso) | 25.38 | ±3.16 | 0.711 | 0.676 | 462 |
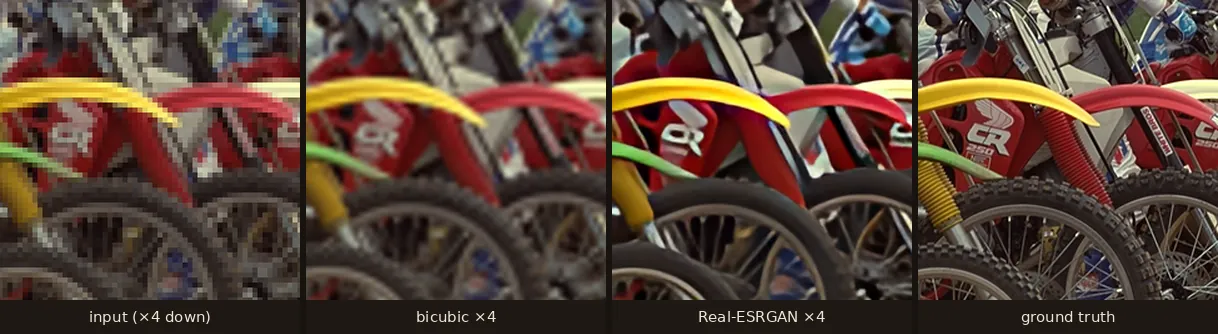
*Entrada de 192×128, hardware classe contêiner de 2 vCPUs; as razões se transferem, os milissegundos não. Se o PSNR fosse a história toda, colocaríamos o Lanczos-3 em produção e apagaríamos 4.9 MB de rede neural. Mas plote cada método no eixo da fidelidade contra o eixo da nitidez e o grupo se divide em duas espécies:
O SSIM (projetado para acompanhar a estrutura percebida em vez do erro bruto[2]) fica no meio do caminho e toma o lado, por pouco, do modelo: melhor média do grupo no geral, e um 0.704 vs 0.694 mais claro no subconjunto Kodak, onde a textura fina domina. Por que a interpolação não consegue competir em nitidez? Porque todo kernel clássico é um operador linear e invariante a deslocamento: ele só consegue redistribuir as frequências que sobreviveram à redução, nunca criar as que não sobreviveram. O limite de Nyquist não é uma sugestão. Um prior GAN contorna o limite mudando a pergunta: de “que sinal produziu estas amostras?” (sem resposta) para “de todas as imagens naturais que se reduziriam a isto, qual é a mais plausível?”[1] É também exatamente aí que mora o seu risco: plausível não é verdadeiro.
3 · O problema do grão de filme, quantificado
As médias escondem o achado mais útil. Divida o corpus e os deltas de PSNR por imagem (Real-ESRGAN − Lanczos-3) são nitidamente bimodais: em quadros modernos limpos o modelo fica a menos de um decibel (ele vence o Lanczos de forma direta em um, +0.15 dB); nas quatro digitalizações históricas de filme ele perde catastroficamente: as médias do subconjunto são 28.75 vs 32.12 dB:
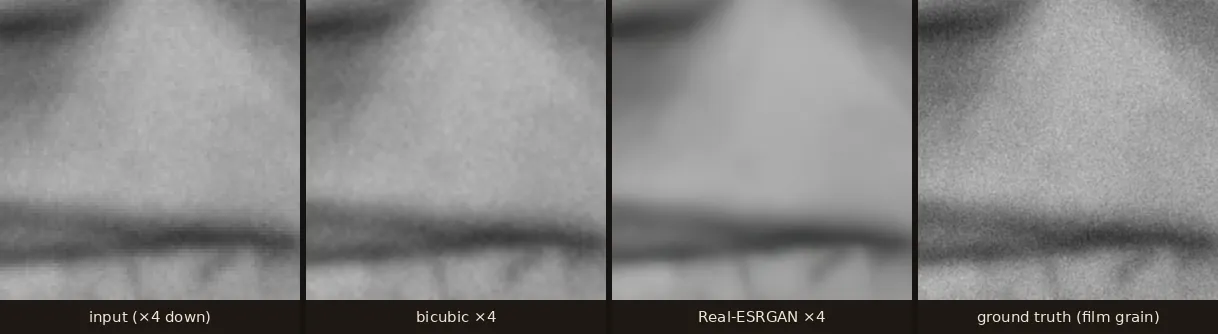
Sob uma lupa os números se tornam óbvios: a digitalização do ground truth é uma parede de grão honesto, e o modelo devolve porcelana. Em Migrant Mother ele cai 1.71 dB e 0.064 de SSIM, e alguns observadores ainda vão preferir a saída limpa. Métricas não são gosto; são um contrato sobre qual gosto você está otimizando. Esta medição é o motivo de a etapa de aprimoramento pular fotos já perto do seu alvo de resolução (uma digitalização de arquivo em alta resolução mantém seus pixels nativos e seu grão), e de a nossa renderização de rostos mesclar o grão da própria fotografia de volta sobre os rostos restaurados em vez de entregar a porcelana do modelo.
4 · Limitações
- Nenhuma métrica perceptual aprendida. LPIPS ou DISTS afiariam o eixo da percepção; o Tenengrad é um substituto honesto, mas mais simples. Os registros brutos estão publicados para que qualquer um possa repontuar.
- Uma única degradação. A bicúbica ×4 é o protocolo padrão e o caso mais gentil; digitalizações reais acrescentam kernels de desfoque, JPEG e ruído (a nota sobre rostos usa a pilha completa de corrupção).
- N = 28: bastante para estes tamanhos de efeito (a ordenação é estável sob leave-one-out), pouco para afirmações sobre subgrupos além da divisão pelo grão.
5 · Conclusão
Medida como reconstrução de sinal, a super-resolução por IA é um interpolador pior que o Lanczos-3: 1.07 dB pior aqui, exatamente como o compromisso percepção–distorção prevê[3]. Medida como reconstrução de fotografia (estrutura, energia de bordas e os seus olhos), não chega perto, na direção oposta. A leitura prática para a sua caixa de sapatos: para fotos que serão vistas por pessoas, o modelo é o padrão certo; para matrizes de arquivo em que cada partícula de grão é evidência, guarde também a digitalização bruta. A ferramenta de restauração é construída em torno exatamente dessa divisão.
Referências
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Wang, Z., Bovik, A. C., Sheikh, H. R., & Simoncelli, E. P. (2004). Image Quality Assessment: From Error Visibility to Structural Similarity. IEEE Transactions on Image Processing, 13(4), 600–612. doi.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai