KI-Upscaling vs. bikubisch: ein Benchmark mit 28 Bildern
Jedes Foto-Tool verspricht heute zu „verbessern“. Unseres lässt Real-ESRGAN[1] laufen, also schuldeten wir einer unbequemen Frage eine Antwort: Wenn man so misst, wie die Bildverarbeitungsliteratur misst, schlägt die KI dann tatsächlich schlichte bikubische Interpolation? Das Ergebnis ist die interessanteste Art von Antwort (nein, und auch ein nachdrückliches Ja), und die Kluft zwischen diesen beiden Antworten hat in der Literatur einen Namen: der Perception-Distortion-Tradeoff[3]. Diese Notiz zeigt den vollständigen Benchmark, einschließlich des Falls, in dem die KI klar verliert (Filmkorn), und warum wir das Modell, das den klassischen Benchmark verliert, trotzdem ausliefern.
Jede Zahl in dieser Notiz wurde mit dem Code der Produktions-Pipeline gemessen: dieselben Modelle, dieselbe Mathematik. Rohdaten pro Bild: e1_sr.json.
1 · Methode
Der Korpus ist die 24 Bilder umfassende Kodak Lossless True Color Suite[4] (der 768×512-Referenzsatz, auf den sich die Kompressions- und Super-Resolution-Literatur seit drei Jahrzehnten stützt), plus vier 768×512-Ausschnitte aus hochauflösenden Scans historischer Fotografien, darunter Dorothea Langes Migrant Mother von 1936[5], denn diese Seite existiert für alte Fotos, und alte Fotos haben Filmkorn. Diese Unterscheidung entscheidet Abschnitt 3.
Wir bewerten drei Dinge. Treue, als Spitzen-Signal-Rausch-Verhältnis über RGB:
strukturelle Ähnlichkeit (SSIM[2], Luma, das übliche 11×11-Gauß-Fenster, σ = 1,5, K₁ = 0,01, K₂ = 0,03):
und Schärfe als Tenengrad-Maß (mittlere quadrierte Sobel-Gradientenstärke), angegeben als Wiederherstellungsverhältnis, Tenengrad(Ausgabe) ÷ Tenengrad(Ground Truth). Ein Verhältnis von 1,0 würde bedeuten, dass die Rekonstruktion so viel Kantenenergie trägt wie die Originalfotografie.
2 · Ergebnisse: der Tradeoff, live
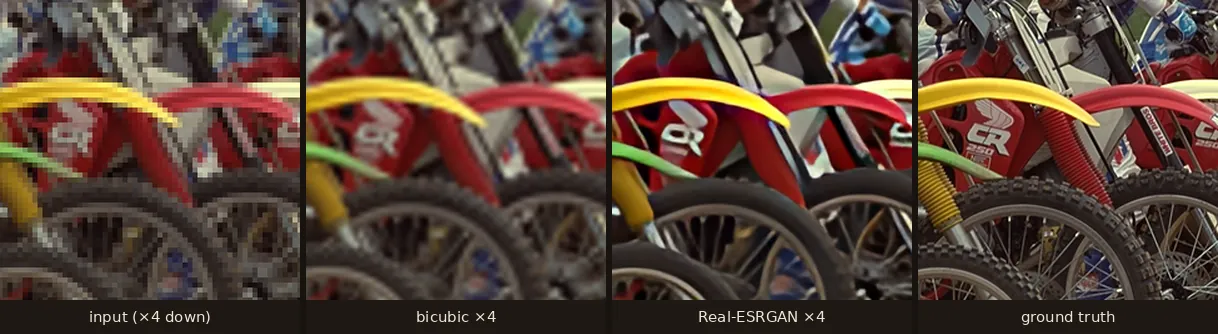
Bei der Metrik, die alle berichten, verhält sich die klassische Leiter genau so, wie die Abtasttheorie es vorhersagt (jeder bessere Kernel kauft einen Bruchteil eines Dezibels), und Real-ESRGAN landet auf dem vorletzten Platz:
| Verfahren | PSNR (dB) | σ | SSIM | Tenengrad-Verhältnis | ms / Bild* |
|---|---|---|---|---|---|
| Nächster Nachbar | 25.42 | ±3.42 | 0.673 | 0.382 | 8 |
| Bilinear | 25.88 | ±3.62 | 0.687 | 0.152 | 236 |
| Bikubisch (Catmull-Rom) | 26.29 | ±3.68 | 0.705 | 0.196 | 343 |
| Lanczos-3 | 26.45 | ±3.71 | 0.711 | 0.216 | 876 |
| Real-ESRGAN ×4 (unseres) | 25.38 | ±3.16 | 0.711 | 0.676 | 462 |
*192×128-Input, 2-vCPU-Container-Hardware; Verhältnisse sind übertragbar, Millisekunden nicht. Wäre PSNR die ganze Geschichte, würden wir Lanczos-3 ausliefern und 4,9 MB neuronales Netz löschen. Aber trage jedes Verfahren auf der Treue-Achse gegen die Schärfe-Achse auf, und das Feld spaltet sich in zwei Spezies:
SSIM (entworfen, um die wahrgenommene Struktur statt des rohen Fehlers zu verfolgen[2]) teilt die Differenz und stellt sich knapp auf die Seite des Modells: bester Mittelwert des Feldes insgesamt und ein deutlicheres 0,704 vs. 0,694 auf der Kodak-Teilmenge, wo feine Textur dominiert. Warum kann Interpolation bei der Schärfe nicht mithalten? Weil jeder klassische Kernel ein linearer, verschiebungsinvarianter Operator ist: Er kann nur die Frequenzen umverteilen, die das Herunterskalieren überlebt haben, nie die erzeugen, die es nicht getan haben. Die Nyquist-Grenze ist kein Vorschlag. Ein GAN-Prior umgeht die Grenze, indem er die Frage ändert: von „welches Signal hat diese Abtastwerte erzeugt?“ (unbeantwortbar) zu „welches von allen natürlichen Bildern, die sich auf dieses herunterskalieren würden, ist am plausibelsten?“[1] Genau dort liegt auch sein Risiko: plausibel ist nicht wahr.
3 · Das Filmkorn-Problem, quantifiziert
Mittelwerte verbergen den nützlichsten Befund. Teile den Korpus auf, und die PSNR-Differenzen pro Bild (Real-ESRGAN − Lanczos-3) sind scharf bimodal: Auf sauberen modernen Bildern liegt das Modell innerhalb eines Dezibels (auf einem schlägt es Lanczos glatt, +0,15 dB); auf den vier historischen Filmscans verliert es katastrophal: Die Teilmengen-Mittelwerte sind 28,75 vs. 32,12 dB:
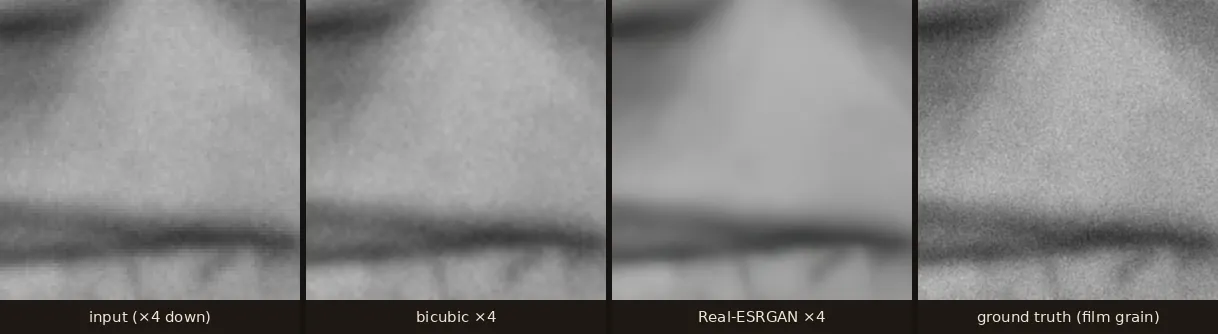
Unter der Lupe werden die Zahlen offensichtlich: Der Ground-Truth-Scan ist eine Wand aus ehrlichem Korn, und das Modell liefert Porzellan. Auf Migrant Mother verliert es 1,71 dB und 0,064 SSIM, und manche Betrachter werden die saubere Ausgabe trotzdem bevorzugen. Metriken sind kein Geschmack; sie sind ein Vertrag darüber, für welchen Geschmack man optimiert. Diese Messung ist der Grund, warum die Verbesserungsstufe Fotos überspringt, die bereits nahe an ihrem Auflösungsziel liegen (ein hochauflösender Archivscan behält seine nativen Pixel und sein Korn), und warum unser Gesichts-Rendering das eigene Korn der Fotografie wieder über restaurierte Gesichter blendet, statt das Porzellan des Modells auszuliefern.
4 · Einschränkungen
- Keine gelernte Wahrnehmungsmetrik. LPIPS oder DISTS würden die Wahrnehmungsachse schärfen; Tenengrad ist ein ehrlicher, aber einfacherer Stellvertreter. Die Rohdaten sind veröffentlicht, sodass jeder neu bewerten kann.
- Eine Degradation. Bikubisch ×4 ist das Standardprotokoll und der freundlichste Fall; echte Scans bringen Unschärfe-Kernel, JPEG und Rauschen mit (die Gesichts-Notiz verwendet den vollständigen Korruptions-Stack).
- N = 28: reichlich für diese Effektgrößen (die Reihenfolge ist unter Leave-one-out stabil), klein für Teilgruppen-Aussagen jenseits der Korn-Aufteilung.
5 · Fazit
Gemessen als Signalrekonstruktion ist KI-Super-Resolution ein schlechterer Interpolator als Lanczos-3: hier 1,07 dB schlechter, genau wie der Perception-Distortion-Tradeoff es vorhersagt[3]. Gemessen als Fotografie-Rekonstruktion (Struktur, Kantenenergie und deine Augen) ist es nicht knapp, in die andere Richtung. Die praktische Lesart für deinen Schuhkarton: Für Fotos, die von Menschen angeschaut werden, ist das Modell der richtige Standard; für Archiv-Master, bei denen jedes Kornpartikel ein Beweisstück ist, behalte auch den Rohscan. Das Restaurierungs-Tool ist genau um diese Aufteilung herum gebaut.
Quellen
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Wang, Z., Bovik, A. C., Sheikh, H. R., & Simoncelli, E. P. (2004). Image Quality Assessment: From Error Visibility to Structural Similarity. IEEE Transactions on Image Processing, 13(4), 600–612. doi.org
- Blau, Y., & Michaeli, T. (2018). The Perception-Distortion Tradeoff. CVPR. arXiv:1711.06077. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- Lange, D. (1936). “Migrant Mother” (Destitute pea pickers in California), Farm Security Administration. Public domain, via Wikimedia Commons. commons.wikimedia.org
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai