Wie stark soll KI-Verbesserung hochskalieren? Ein begrenztes Design
Super-Resolution-Modelle sind quadratisch: Verdopple die Kante des Inputs und du vervierfachst die Arbeit, und die Wartezeit. Lässt man eines naiv über alles laufen, was Leute hochladen, dauert ein 40-Megapixel-Scan Minuten, während ein Handyschnappschuss Sekunden braucht. Unsere Verbesserungsstufe plant stattdessen jeden Auftrag so, dass die Arbeitslast des Modells immer dieselbe begrenzte Größe hat, egal was ankommt. Diese Notiz gibt die Planungsregel an und, neu in dieser Überarbeitung, die Messungen hinter ihren beiden tragenden Behauptungen: dass die Kosten linear sind, sobald sie begrenzt sind (~15,6 s pro Input-Megapixel auf dem Testrechner, r² > 0,999), und dass gekachelte Inferenz nur deshalb visuell nahtlos ist, weil jede Kachel 8 px Kontext mitbringt, was 87 % der Nahtenergie entfernt, die Zero-Padding hinterlässt.
Jede Zahl in dieser Notiz wurde mit dem Code der Produktions-Pipeline gemessen: dieselben Modelle, dieselbe Mathematik. Rohdaten pro Bild: e6_tiles.json.
1 · Die Planungsregel
Die Stufe zielt auf eine Ausgabe von höchstens 2560 px auf der langen Kante und verwendet dafür ein 4×-Super-Resolution-Modell[1]. Rückwärts gerechnet braucht das Modell nie einen Input, der länger ist als 2560 ÷ 4 = 640 px, also verkleinert der Planer alles, was ankommt, vorab auf diese Grenze, bevor das Modell läuft, und deckelt den Modell-Input bei etwa 0,41 Megapixeln, egal ob der Upload 1 MP oder 40 MP hatte. Formal, für einen Upload mit langer Kante L:
Drei Leitplanken vervollständigen die Regel: Die Ausgabe landet nie unter der Originalauflösung (Verbesserung darf dich nie Pixel kosten), Inputs, die bereits nahe am oder über dem Ziel liegen, überspringen den Durchgang komplett (die 1,3×-Mindestgewinn-Klausel, denn darunter verwischt die Hin-und-zurück-Runde aus Resampling und Modell etwa so viel, wie sie schärft), und Gesichter werden nach dem Durchgang restauriert, sodass Gesichtsausschnitte in der verbesserten Auflösung ins Gesichtsmodell gelangen.
2 · Warum überhaupt eine Grenze: Kosten sind linear, nachdem man sie dazu gemacht hat
Die Behauptung, die das ganze Design motiviert, ist messbar, also haben wir sie gemessen: der Produktions-Upscale-Pfad (192-px-Kacheln, 8 px Padding, ONNX Runtime CPU[3]) über Inputs von 0,04 bis 0,39 Megapixel auf 2-vCPU-Container-Hardware:
Ein zweiter Engineering-Fakt fällt aus demselben Durchlauf heraus: Die Gesamtlaufzeit ist im Wesentlichen unabhängig von der Kachelgröße (96 → 384 px landen alle innerhalb von 8 % voneinander): Die Arbeit ist pro Pixel, und der Padding-Overhead bei 8 px ist Rauschen. Die Kachelgröße wird daher wegen des Speichers gewählt, nicht wegen der Geschwindigkeit: 192 px hält den Spitzentensor klein genug für den WASM-Heap der Browser-Fallback-Engine.
3 · Die Nahtsteuer, und warum 8 px Kontext sie bezahlen
Kacheln hat einen Fehlermodus, bei dem sich die Papers selten aufhalten: Faltungen haben rezeptive Felder, also ist eine Kachel, die ohne umgebenden Kontext geschnitten wird, an ihrem Rand falsch, und das wieder zusammengesetzte Mosaik zeigt ein Raster. Wir messen es mit einem Nahtindex: mittlerer Luma-Gradient über die Pixelspalten an den Kachelgrenzen geteilt durch den mittleren Gradienten anderswo; 1,0 bedeutet, die Grenzen sind statistisch unsichtbar:
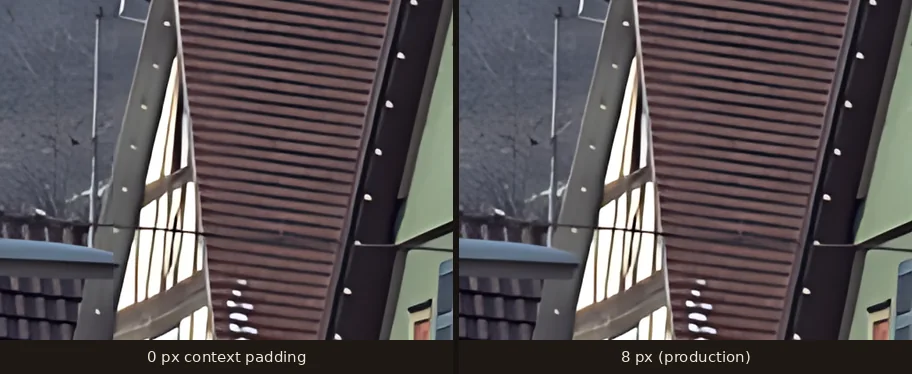
Die Form dieser Kurve ist das Designargument im Kleinen: Die ersten zwei Pixel Kontext kaufen die Hälfte der Verbesserung, acht kaufen abnehmende Erträge, und jenseits von acht zahlt man quasi-quadratischen Padding-Overhead für Nahtenergie, die kein Betrachter finden kann. (Ob die verbesserten Pixel selbst klassische Interpolation schlagen, ist eine separate Frage mit einer gemessenen Antwort; siehe den Benchmark mit 28 Bildern, wo das Modell 1,07 dB PSNR an Lanczos-3 abgibt und 3,1× so viel Kantenenergie wiederherstellt[2].)
4 · Gemessene Zeiten, End-to-End
Benchmark: ein 821×1024-Schwarzweiß-Scan, restauriert auf 2052×2560, koloriert, ein Gesicht, auf einer warmen Instanz.
End-to-End in der Produktion am selben Foto: 68 s beim Kaltstart (Laden der Modellgewichte) und 32 s warm. Zur Einordnung: Die vorherige Pipeline, die nichts hochskalierte und nur Gesichter anfasste, lief 23–34 s warm; der begrenzte Ganzbild-Durchgang fügt der Laufzeit fast nichts hinzu, weil sein Input per Konstruktion klein ist. Und wenn derselbe Auftrag im Browser läuft (der automatische Fallback), brauchte ein 1000×1223-Scan 340,8 s auf einem Apple-Silicon-Desktop mit WebGPU (derselbe begrenzte Plan, etwa 10× die Laufzeit). Die Grenze ist das, was selbst diesen Worst Case benutzbar statt unbegrenzt hält.
5 · Was verworfen wurde
Diffusionsbasierte Super-Resolution (viel zu langsam für ein interaktives Tool auf unserem Stack), größere Gesichtsrestaurierungsmodelle als Standard (die Zeit pro Gesicht explodiert bei Gruppenfotos) und das Senden von Fotos an externe GPU-Inferenz-APIs: Fotos würden unsere Infrastruktur verlassen, was das Datenschutzversprechen ausschließt. Der begrenzte Plan behält Qualitätsgewinne dort, wo ein Betrachter sie tatsächlich wahrnimmt, in einem bildschirmgroßen Bild, statt quadratisch für Pixel zu zahlen, die niemand sehen kann.
6 · Einschränkungen
Das 2560-px-Ziel ist eine Produktentscheidung, kein Optimum: Drucke profitieren von mehr Auflösung, und eine künftige kostenpflichtige Stufe könnte die Grenze anheben. Die Zeiten oben sind der Normalfall: Fotos voller Gesichter verbringen anteilig mehr Zeit in der Gesichtsstufe, die die Verbesserungsgrenze nicht abdeckt. Und der Nahtindex ist ein statistisches Instrument: Er bescheinigt, dass Grenzen im Mittel ruhig sind, nicht, dass keine widrige Textur jemals eine offenbaren könnte.
Quellen
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai