¿Cuánto debe ampliar la mejora con IA? Un diseño acotado
Los modelos de superresolución son cuadráticos: duplica el lado de la entrada y cuadruplicas el trabajo, y la espera. Ejecuta uno ingenuamente sobre lo que la gente suba y un escaneo de 40 megapíxeles tarda minutos mientras una foto de teléfono tarda segundos. Nuestra etapa de mejora, en cambio, planifica cada trabajo para que la carga del modelo tenga el mismo tamaño acotado sin importar lo que llegue. Esta nota da la regla de planificación y, nuevo en esta revisión, las mediciones detrás de sus dos afirmaciones de peso: que el coste es lineal una vez acotado (~15.6 s por megapíxel de entrada en la máquina del banco, r² > 0.999), y que la inferencia por teselas es visualmente continua solo porque cada tesela lleva 8 px de contexto, lo que elimina el 87% de la energía de costura que deja el relleno con ceros.
Cada cifra de esta nota se midió con el código del pipeline de producción: los mismos modelos, las mismas matemáticas. Registros brutos por imagen: e6_tiles.json.
1 · La regla de planificación
La etapa apunta a una salida de como máximo 2560 px en el lado largo, usando un modelo de superresolución 4×[1]. Yendo hacia atrás, el modelo nunca necesita una entrada de más de 2560 ÷ 4 = 640 px, así que el planificador reduce previamente lo que llegue a esa cota antes de ejecutar el modelo, limitando la entrada del modelo a unos 0.41 megapíxeles tanto si la subida era de 1 MP como de 40 MP. Formalmente, para una subida con lado largo L:
Tres salvaguardas completan la regla: la salida nunca queda por debajo de la resolución original (la mejora nunca debe costarte píxeles), las entradas ya cercanas o superiores al objetivo omiten la pasada por completo (la cláusula de ganancia mínima de 1.3×, porque por debajo de eso el viaje de ida y vuelta de remuestreo y modelo emborrona casi tanto como enfoca), y las caras se restauran después de la pasada, de modo que los recortes de cara entran en el modelo facial con la resolución mejorada.
2 · Por qué una cota: el coste es lineal, después de hacer que lo sea
La afirmación que motiva todo el diseño es medible, así que la medimos: la ruta de ampliación de producción (teselas de 192 px, 8 px de relleno, ONNX Runtime CPU[3]) ejecutada sobre entradas de 0.04 a 0.39 megapíxeles en hardware de clase contenedor de 2 vCPU:
Del mismo barrido sale un segundo hecho de ingeniería: el tiempo total de ejecución es esencialmente independiente del tamaño de tesela (de 96 → 384 px, todos caen dentro de un 8% entre sí): el trabajo es por píxel, y la sobrecarga del relleno a 8 px es ruido. El tamaño de tesela se elige, por tanto, por memoria, no por velocidad: 192 px mantiene el tensor máximo lo bastante pequeño para el heap WASM del motor de respaldo del navegador.
3 · El impuesto de costura, y por qué 8 px de contexto lo pagan
El teselado tiene un modo de fallo en el que los artículos rara vez se detienen: las convoluciones tienen campos receptivos, así que una tesela cortada sin contexto circundante está equivocada a lo largo de su borde, y el mosaico reensamblado muestra una rejilla. Lo medimos con un índice de costura: el gradiente medio de luma a través de las columnas de píxeles en los bordes de las teselas dividido por el gradiente medio en el resto; 1.0 significa que los bordes son estadísticamente invisibles:
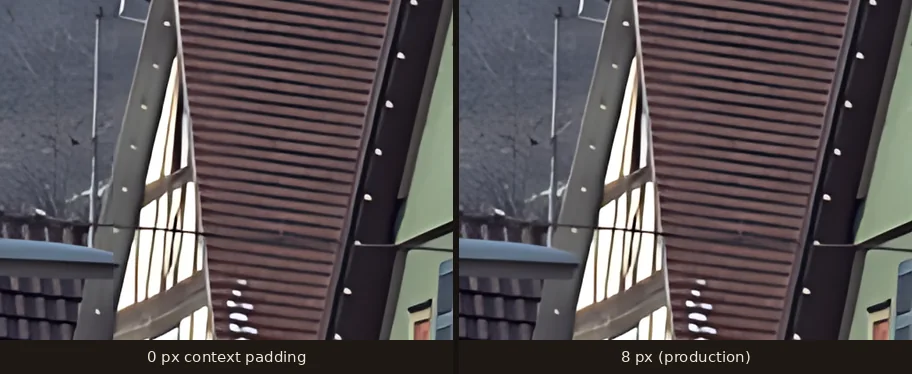
La forma de esa curva es el argumento de diseño en miniatura: los dos primeros píxeles de contexto compran la mitad de la mejora, ocho compran rendimientos decrecientes, y pasados los ocho estás pagando una sobrecarga de relleno casi cuadrática por una energía de costura que ningún espectador puede encontrar. (Si los propios píxeles mejorados superan a la interpolación clásica es una pregunta aparte con respuesta medida; consulta el benchmark de 28 imágenes, donde el modelo cede 1.07 dB de PSNR frente a Lanczos-3 y restaura 3.1× la energía de bordes[2].)
4 · Tiempos medidos, de extremo a extremo
Benchmark: un escaneo en blanco y negro de 821×1024 restaurado a 2052×2560, coloreado, una cara, en una instancia caliente.
De extremo a extremo en producción con la misma foto: 68 s en arranque en frío (carga de los pesos de los modelos) y 32 s en caliente. Para dar escala: el pipeline anterior, que no ampliaba nada y solo tocaba las caras, tardaba 23–34 s en caliente; la pasada acotada sobre la imagen entera añade casi nada al tiempo de reloj, porque su entrada es pequeña por construcción. Y cuando el mismo trabajo se ejecuta dentro del navegador (el respaldo automático), un escaneo de 1000×1223 tardó 340.8 s en un equipo de escritorio con Apple Silicon y WebGPU (el mismo plan acotado, unas 10× el tiempo de reloj). La cota es lo que mantiene utilizable incluso ese peor caso en lugar de ilimitado.
5 · Lo que se rechazó
La superresolución basada en difusión (demasiado lenta para una herramienta interactiva en nuestra pila), modelos de restauración por cara más grandes como opción por defecto (el tiempo por cara se dispara en las fotos de grupo) y enviar fotos a API externas de inferencia en GPU: las fotos saldrían de nuestra infraestructura, algo que la promesa de privacidad descarta. El plan acotado mantiene las ganancias de calidad donde un espectador realmente las percibe, una imagen de tamaño de pantalla, en lugar de pagar cuadráticamente por píxeles que nadie puede ver.
6 · Limitaciones
El objetivo de 2560 px es una decisión de producto, no un óptimo: las impresiones se benefician de más resolución, y un futuro nivel de pago podría elevar la cota. Los tiempos anteriores son el caso común: las fotos densas en caras pasan proporcionalmente más tiempo en la etapa facial, que la cota de la mejora no cubre. Y el índice de costura es un instrumento estadístico: certifica que los bordes son tranquilos en promedio, no que ninguna textura adversarial pueda revelar alguno.
Referencias
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai