Jusqu'où l'amélioration par IA doit-elle agrandir ? Une conception bornée
Les modèles de super-résolution sont quadratiques : double le côté de l'entrée et tu quadruples le travail, et l'attente. Fais-en tourner un naïvement sur tout ce que les gens envoient et un scan de 40 mégapixels prend des minutes tandis qu'une photo de téléphone prend des secondes. Notre étape d'amélioration planifie au contraire chaque tâche pour que la charge de travail du modèle ait la même taille bornée quoi qu'il arrive. Cette note donne la règle de planification et, nouveau dans cette révision, les mesures derrière ses deux affirmations porteuses : que le coût est linéaire une fois borné (~15,6 s par mégapixel d'entrée sur la machine de test, r² > 0,999), et que l'inférence par tuiles n'est visuellement sans raccord que parce que chaque tuile emporte 8 px de contexte, ce qui retire 87 % de l'énergie de raccord que laisse un remplissage à zéro.
Chaque chiffre de cette note a été mesuré sur le code du pipeline de production : mêmes modèles, mêmes calculs. Données brutes par image : e6_tiles.json.
1 · La règle de planification
L'étape vise une sortie d'au plus 2560 px sur le grand côté, avec un modèle de super-résolution 4×[1]. En remontant, le modèle n'a jamais besoin d'une entrée plus longue que 2560 ÷ 4 = 640 px, si bien que le planificateur pré-réduit tout ce qui arrive à cette borne avant que le modèle ne tourne, plafonnant l'entrée du modèle autour de 0,41 mégapixel, que l'envoi fasse 1 MP ou 40 MP. Formellement, pour un envoi de grand côté L :
Trois garde-fous complètent la règle : la sortie ne descend jamais sous la résolution d'origine (l'amélioration ne doit jamais te coûter des pixels), les entrées déjà proches de la cible ou au-dessus sautent entièrement la passe (la clause de gain minimal de 1,3×, parce qu'en dessous l'aller-retour rééchantillonnage-modèle floute à peu près autant qu'il affine), et les visages sont restaurés après la passe, pour que les recadrages de visages entrent dans le modèle de visages à la résolution améliorée.
2 · Pourquoi une borne : le coût est linéaire, une fois qu'on l'y force
L'affirmation qui motive toute la conception est mesurable, alors nous l'avons mesurée : le chemin d'agrandissement de production (tuiles de 192 px, marge de 8 px, ONNX Runtime CPU[3]) exécuté sur des entrées de 0,04 à 0,39 mégapixel sur du matériel de classe conteneur à 2 vCPU :
Un second fait d'ingénierie sort du même balayage : le temps total est essentiellement indépendant de la taille des tuiles (de 96 → 384 px, tout tombe à 8 % près) : le travail est par pixel, et le surcoût de marge à 8 px est du bruit. La taille des tuiles se choisit donc pour la mémoire, pas pour la vitesse : 192 px garde le tenseur de pointe assez petit pour le tas WASM du moteur de repli du navigateur.
3 · La taxe de raccord, et pourquoi 8 px de contexte la paient
Le tuilage a un mode d'échec sur lequel les articles s'attardent rarement : les convolutions ont des champs récepteurs, si bien qu'une tuile découpée sans contexte environnant est fausse le long de sa bordure, et la mosaïque réassemblée montre une grille. Nous le mesurons avec un indice de raccord : gradient de luma moyen sur les colonnes de pixels aux frontières des tuiles, divisé par le gradient moyen ailleurs ; 1,0 veut dire que les frontières sont statistiquement invisibles :
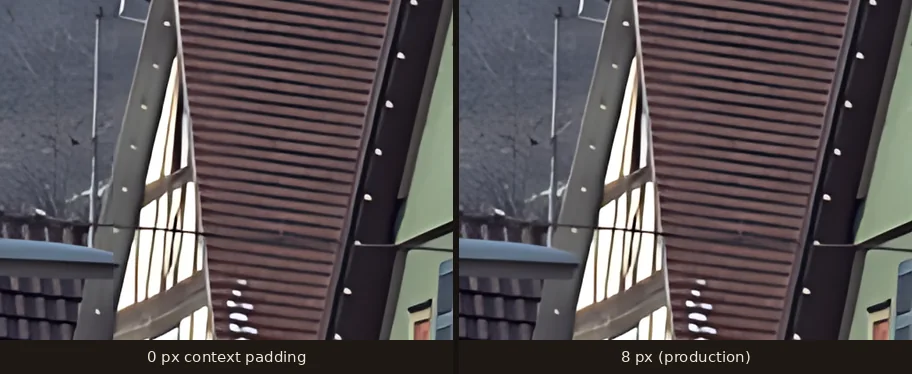
La forme de cette courbe est l'argument de conception en miniature : les deux premiers pixels de contexte achètent la moitié de l'amélioration, huit achètent des rendements décroissants, et au-delà de huit tu paies un surcoût de marge quasi quadratique pour une énergie de raccord qu'aucun spectateur ne peut trouver. (Savoir si les pixels améliorés eux-mêmes battent l'interpolation classique est une question distincte, avec une réponse mesurée ; voir le banc de 28 images, où le modèle cède 1,07 dB de PSNR à Lanczos-3 et restaure 3,1× l'énergie de contours[2].)
4 · Temps mesurés, de bout en bout
Référence : un scan noir et blanc de 821×1024 restauré en 2052×2560, colorisé, un visage, sur une instance chaude.
De bout en bout en production sur la même photo : 68 s à froid (chargement des poids des modèles) et 32 s à chaud. Pour l'échelle : le pipeline précédent, qui n'agrandissait rien et ne touchait qu'aux visages, tournait en 23–34 s à chaud ; la passe bornée sur l'image entière n'ajoute presque rien au temps écoulé, parce que son entrée est petite par construction. Et quand la même tâche tourne dans le navigateur (le repli automatique), un scan de 1000×1223 a pris 340,8 s sur un ordinateur de bureau Apple Silicon avec WebGPU (même plan borné, environ 10× le temps écoulé). La borne est ce qui garde même ce pire cas utilisable plutôt qu'illimité.
5 · Ce qui a été rejeté
La super-résolution par diffusion (bien trop lente pour un outil interactif sur notre pile), des modèles de restauration de visages plus gros par défaut (le temps par visage explose sur les photos de groupe), et l'envoi des photos à des API d'inférence GPU externes : les photos quitteraient notre infrastructure, ce que la promesse de confidentialité exclut. Le plan borné garde les gains de qualité là où un spectateur les perçoit réellement, une image de la taille d'un écran, au lieu de payer quadratiquement pour des pixels que personne ne peut voir.
6 · Limites
La cible de 2560 px est une décision produit, pas un optimum : les impressions profitent de plus de résolution, et un futur palier payant pourrait relever la borne. Les temps ci-dessus sont le cas courant : les photos denses en visages passent proportionnellement plus de temps dans l'étape des visages, que la borne d'amélioration ne couvre pas. Et l'indice de raccord est un instrument statistique : il certifie que les frontières sont calmes en moyenne, pas qu'aucune texture adverse ne pourrait jamais en révéler une.
Références
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai