Quanto o aprimoramento por IA deve ampliar? Um projeto com limite
Modelos de super-resolução são quadráticos: dobre o lado da entrada e você quadruplica o trabalho, e a espera. Rode um ingenuamente sobre o que quer que as pessoas enviem e uma digitalização de 40 megapixels leva minutos enquanto uma foto de celular leva segundos. Nossa etapa de aprimoramento, em vez disso, planeja cada trabalho para que a carga do modelo tenha o mesmo tamanho limitado, não importa o que chegue. Esta nota apresenta a regra de planejamento e, novidade nesta revisão, as medições por trás das suas duas afirmações estruturais: que o custo é linear uma vez limitado (~15.6 s por megapixel de entrada na máquina de bancada, r² > 0.999), e que a inferência em blocos só é visualmente sem emendas porque cada bloco carrega 8 px de contexto, o que remove 87% da energia de emenda que o preenchimento com zeros deixa para trás.
Cada número desta nota foi medido no código do pipeline de produção: os mesmos modelos, a mesma matemática. Registros brutos por imagem: e6_tiles.json.
1 · A regra de planejamento
A etapa mira uma saída de no máximo 2560 px no lado maior, usando um modelo de super-resolução 4×[1]. Trabalhando de trás para a frente, o modelo nunca precisa de uma entrada com mais de 2560 ÷ 4 = 640 px, então o planejador pré-reduz o que quer que chegue a esse limite antes de o modelo rodar, limitando a entrada do modelo a cerca de 0.41 megapixels, tenha o envio 1 MP ou 40 MP. Formalmente, para um envio com lado maior L:
Três salvaguardas completam a regra: a saída nunca fica abaixo da resolução original (o aprimoramento nunca deve custar pixels a você), entradas já perto ou acima do alvo pulam a passagem inteiramente (a cláusula de ganho mínimo de 1.3×, porque abaixo disso a ida e volta de reamostragem e modelo borra mais ou menos tanto quanto realça), e os rostos são restaurados depois da passagem, para que os recortes de rosto entrem no modelo de rostos na resolução melhorada.
2 · Por que um limite, afinal: o custo é linear, depois que você o torna linear
A afirmação que motiva o projeto inteiro é mensurável, então a medimos: o caminho de ampliação de produção (blocos de 192 px, 8 px de padding, ONNX Runtime em CPU[3]) rodado sobre entradas de 0.04 a 0.39 megapixels em hardware classe contêiner de 2 vCPUs:
Um segundo fato de engenharia sai da mesma varredura: o tempo total de execução é essencialmente independente do tamanho do bloco (96 → 384 px caem todos dentro de 8% uns dos outros): o trabalho é por pixel, e a sobrecarga do padding de 8 px é ruído. O tamanho do bloco é, portanto, escolhido pela memória, não pela velocidade: 192 px mantém o tensor de pico pequeno o bastante para o heap WASM do motor de reserva do navegador.
3 · O imposto da emenda, e por que 8 px de contexto o pagam
A divisão em blocos tem um modo de falha em que os artigos raramente se detêm: convoluções têm campos receptivos, então um bloco cortado sem contexto ao redor fica errado ao longo da borda, e o mosaico remontado mostra uma grade. Medimos isso com um índice de emenda: gradiente médio de luma nas colunas de pixels das fronteiras entre blocos dividido pelo gradiente médio no resto; 1.0 significa que as fronteiras são estatisticamente invisíveis:
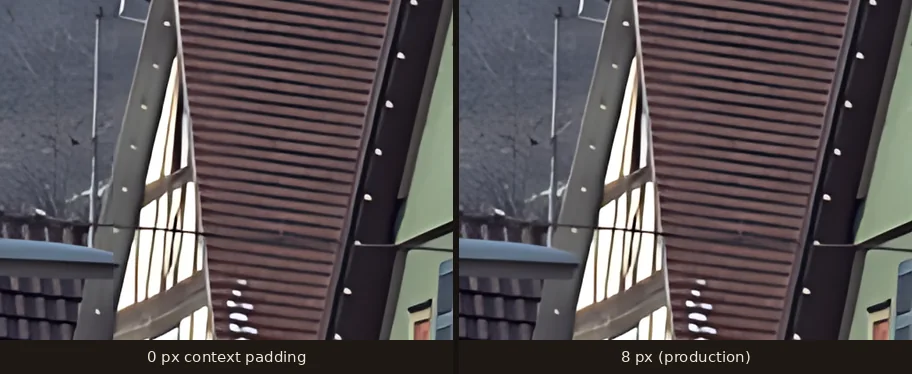
A forma dessa curva é o argumento do projeto em miniatura: os dois primeiros pixels de contexto compram metade da melhoria, oito compram retornos decrescentes, e depois de oito você está pagando uma sobrecarga de padding quase quadrática por uma energia de emenda que nenhum observador consegue encontrar. (Se os pixels aprimorados em si superam a interpolação clássica é uma pergunta separada, com resposta medida; veja o benchmark de 28 imagens, em que o modelo cede 1.07 dB de PSNR ao Lanczos-3 e restaura 3.1× a energia de bordas[2].)
4 · Tempos medidos, de ponta a ponta
Benchmark: uma digitalização em preto e branco de 821×1024 restaurada para 2052×2560, colorida, um rosto, em uma instância aquecida.
De ponta a ponta em produção, na mesma foto: 68 s em uma partida a frio (carregando os pesos do modelo) e 32 s aquecido. Para dar escala: o pipeline anterior, que não ampliava nada e só tocava nos rostos, rodava em 23–34 s aquecido; a passagem limitada sobre a imagem inteira quase não acrescenta nada ao tempo de relógio, porque sua entrada é pequena por construção. E quando o mesmo trabalho roda dentro do navegador (a reserva automática), uma digitalização de 1000×1223 levou 340.8 s em um desktop Apple Silicon com WebGPU (mesmo plano limitado, cerca de 10× o tempo de relógio). O limite é o que mantém até esse pior caso utilizável em vez de ilimitado.
5 · O que foi rejeitado
Super-resolução baseada em difusão (lenta demais para uma ferramenta interativa na nossa stack), modelos maiores de restauração por rosto como padrão (o tempo por rosto explode em fotos de grupo) e enviar fotos a APIs externas de inferência em GPU: as fotos sairiam da nossa infraestrutura, o que a promessa de privacidade descarta. O plano limitado mantém os ganhos de qualidade onde um observador realmente os percebe, uma imagem do tamanho da tela, em vez de pagar quadraticamente por pixels que ninguém consegue ver.
6 · Limitações
O alvo de 2560 px é uma decisão de produto, não um ótimo: impressões se beneficiam de mais resolução, e um futuro plano pago poderia elevar o limite. Os tempos acima são o caso comum: fotos densas em rostos gastam proporcionalmente mais na etapa de rostos, que o limite do aprimoramento não cobre. E o índice de emenda é um instrumento estatístico: certifica que as fronteiras são quietas em média, não que nenhuma textura adversarial jamais poderia revelar uma.
Referências
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai