AI एन्हांसमेंट कितना अपस्केल करे? एक बाउंडेड डिज़ाइन
सुपर-रिज़ॉल्यूशन मॉडल क्वाड्रैटिक हैं: इनपुट की साइड दोगुनी करें और काम चौगुना हो जाता है, और इंतज़ार भी। इसे बिना सोचे-समझे लोगों के हर अपलोड पर चलाएँ तो 40 मेगापिक्सेल का स्कैन मिनटों लेता है जबकि फोन का स्नैप सेकंड। हमारी एन्हांसमेंट स्टेज इसके बजाय हर काम की योजना बनाती है ताकि जो भी आए, मॉडल का वर्कलोड वही सीमित साइज़ का रहे। यह नोट प्लानिंग नियम देता है, और, इस संशोधन में नया, उसके दो भार उठाने वाले दावों के पीछे की माप: कि सीमित करने के बाद लागत लीनियर है (बेंच बॉक्स पर ~15.6 s प्रति इनपुट मेगापिक्सेल, r² > 0.999), और कि टाइल की हुई इन्फरेंस देखने में बिना जोड़ के सिर्फ इसलिए है क्योंकि हर टाइल 8 px का संदर्भ साथ लाती है, जो ज़ीरो-पैडिंग से बची सीम एनर्जी का 87% हटा देता है।
इस नोट का हर आँकड़ा प्रोडक्शन पाइपलाइन के कोड पर मापा गया: वही मॉडल, वही गणित। प्रति इमेज कच्चे रिकॉर्ड: e6_tiles.json.
1 · प्लानिंग नियम
यह स्टेज 4× सुपर-रिज़ॉल्यूशन मॉडल[1] का इस्तेमाल करते हुए लंबी साइड पर ज़्यादा से ज़्यादा 2560 px का आउटपुट टारगेट करती है। उल्टा चलें तो मॉडल को कभी 2560 ÷ 4 = 640 px से लंबे इनपुट की ज़रूरत नहीं, इसलिए प्लानर जो भी आए उसे मॉडल चलने से पहले उस सीमा तक प्री-श्रिंक कर देता है, और मॉडल का इनपुट लगभग 0.41 मेगापिक्सेल पर कैप हो जाता है, चाहे अपलोड 1 MP का हो या 40 MP का। औपचारिक रूप से, लंबी साइड L वाले अपलोड के लिए:
तीन गार्डरेल नियम को पूरा करते हैं: आउटपुट कभी मूल रिज़ॉल्यूशन से नीचे नहीं उतरता (एन्हांसमेंट से आपके पिक्सेल कभी नहीं घटने चाहिए), टारगेट के पास या उससे ऊपर के इनपुट पास को पूरी तरह छोड़ देते हैं (1.3× न्यूनतम-लाभ की शर्त, क्योंकि उससे नीचे रीसैंपल-और-मॉडल का चक्कर जितना शार्प करता है लगभग उतना ही धुंधला भी करता है), और चेहरे पास के बाद रिस्टोर होते हैं, ताकि फेस क्रॉप बेहतर रिज़ॉल्यूशन पर फेस मॉडल में जाएँ।
2 · सीमा क्यों: लागत लीनियर है, जब आप उसे ऐसा बना दें
जो दावा पूरे डिज़ाइन की वजह है वह मापने लायक है, तो हमने मापा: प्रोडक्शन अपस्केल पाथ (192 px टाइलें, 8 px पैडिंग, ONNX Runtime CPU[3]) 2-vCPU कंटेनर-क्लास हार्डवेयर पर 0.04 से 0.39 मेगापिक्सेल के इनपुट पर चलाया गया:
उसी स्वीप से एक दूसरा इंजीनियरिंग तथ्य निकलता है: कुल रनटाइम टाइल साइज़ से लगभग स्वतंत्र है (96 → 384 px सब एक-दूसरे के 8% के भीतर उतरते हैं): काम प्रति-पिक्सेल है, और 8 px पर पैडिंग का ओवरहेड शोर है। इसलिए टाइल साइज़ रफ्तार के लिए नहीं, मेमोरी के लिए चुना जाता है: 192 px पीक टेंसर को ब्राउज़र फ़ॉलबैक इंजन के WASM हीप के लिए काफी छोटा रखता है।
3 · सीम टैक्स, और 8 px का संदर्भ उसे क्यों चुकाता है
टाइलिंग की एक नाकामी है जिस पर शोध-पत्र कम ही रुकते हैं: कन्वोल्यूशन के रिसेप्टिव फील्ड होते हैं, इसलिए बिना आसपास के संदर्भ के काटी गई टाइल अपने किनारे पर गलत होती है, और जोड़ा गया मोज़ेक एक ग्रिड दिखाता है। हम इसे सीम इंडेक्स से मापते हैं: टाइल-सीमा वाले पिक्सेल कॉलम पर औसत ल्यूमा ग्रेडिएंट को बाकी जगह के औसत ग्रेडिएंट से भाग देकर; 1.0 का मतलब है सीमाएँ सांख्यिकीय रूप से अदृश्य हैं:
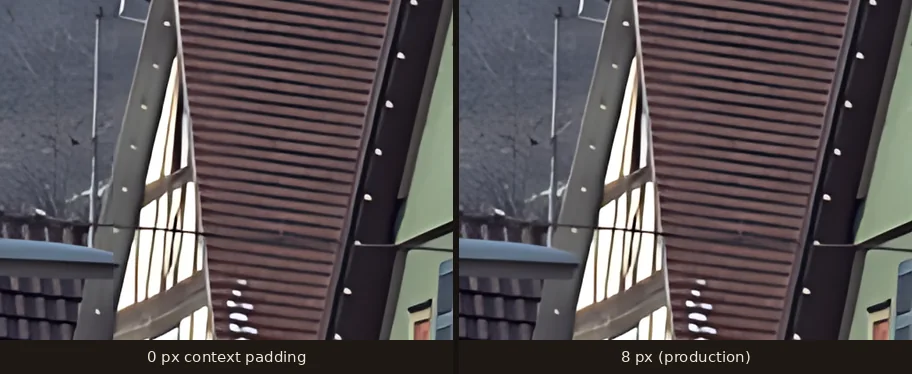
उस कर्व का आकार डिज़ाइन की दलील का छोटा रूप है: संदर्भ के पहले दो पिक्सेल आधा सुधार खरीदते हैं, आठ घटता हुआ लाभ देते हैं, और आठ से आगे आप ऐसी सीम एनर्जी के लिए लगभग-क्वाड्रैटिक पैडिंग ओवरहेड चुका रहे हैं जिसे कोई दर्शक ढूँढ नहीं सकता। (क्या एन्हांस किए पिक्सेल खुद क्लासिकल इंटरपोलेशन को हराते हैं, यह मापे हुए जवाब वाला अलग सवाल है; देखें 28 इमेज का बेंचमार्क, जहाँ मॉडल Lanczos-3 के मुकाबले 1.07 dB PSNR छोड़ता है और 3.1× एज एनर्जी वापस लाता है[2]।)
4 · मापी गई टाइमिंग, शुरू से आखिर तक
बेंचमार्क: 821×1024 का ब्लैक एंड व्हाइट स्कैन 2052×2560 पर रिस्टोर किया गया, रंग भरा गया, एक चेहरा, गर्म इंस्टेंस पर।
उसी फोटो पर प्रोडक्शन में शुरू से आखिर तक: कोल्ड स्टार्ट पर 68 s (मॉडल वेट लोड होते हुए) और गर्म पर 32 s। तुलना के लिए: पिछली पाइपलाइन, जो कुछ भी अपस्केल नहीं करती थी और सिर्फ चेहरों को छूती थी, गर्म पर 23–34 s चलती थी; सीमित पूरी-इमेज वाला पास वॉल-क्लॉक में लगभग कुछ नहीं जोड़ता, क्योंकि उसका इनपुट बनावट से ही छोटा है। और जब वही काम ब्राउज़र के अंदर चलता है (अपने आप वाला फ़ॉलबैक), तो 1000×1223 के स्कैन ने WebGPU वाले Apple-सिलिकॉन डेस्कटॉप पर 340.8 s लिए (वही सीमित योजना, लगभग 10× वॉल-क्लॉक)। सीमा ही है जो उस सबसे बुरी स्थिति को भी असीमित के बजाय इस्तेमाल लायक रखती है।
5 · जो खारिज हुआ
डिफ्यूज़न-आधारित सुपर-रिज़ॉल्यूशन (हमारे स्टैक पर इंटरैक्टिव टूल के लिए बहुत ज़्यादा धीमा), डिफ़ॉल्ट के रूप में बड़े प्रति-चेहरा रिस्टोरेशन मॉडल (ग्रुप फोटो पर प्रति-चेहरा समय फूल जाता है), और फोटो को बाहरी GPU इन्फरेंस API को भेजना: फोटो हमारे इन्फ्रास्ट्रक्चर से बाहर जातीं, जिसे प्राइवेसी का वादा खारिज करता है। सीमित योजना क्वालिटी के फायदे वहाँ रखती है जहाँ दर्शक उन्हें सच में महसूस करता है, स्क्रीन के आकार की इमेज, बजाय उन पिक्सेलों के लिए क्वाड्रैटिक कीमत चुकाने के जिन्हें कोई देख नहीं सकता।
6 · सीमाएँ
2560 px का टारगेट एक प्रोडक्ट फैसला है, ऑप्टिमम नहीं: प्रिंट को ज़्यादा रिज़ॉल्यूशन से फायदा होता है, और भविष्य का कोई पेड टियर सीमा बढ़ा सकता है। ऊपर की टाइमिंग आम मामला है: चेहरों से भरी फोटो आनुपातिक रूप से ज़्यादा समय फेस स्टेज में बिताती हैं, जिसे एन्हांसमेंट की सीमा नहीं ढकती। और सीम इंडेक्स एक सांख्यिकीय उपकरण है: यह प्रमाणित करता है कि सीमाएँ औसतन शांत हैं, यह नहीं कि कोई विरोधी बनावट कभी किसी को उजागर नहीं कर सकती।
संदर्भ
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai