Jak bardzo ulepszanie AI ma powiększać? Ograniczony projekt
Modele superrozdzielczości są kwadratowe: podwój bok wejścia, a czterokrotnie zwiększysz pracę, i czekanie. Uruchom taki model naiwnie na czymkolwiek, co ludzie prześlą, a 40-megapikselowy skan zajmie minuty, podczas gdy fotka z telefonu sekundy. Nasz etap ulepszania planuje zamiast tego każde zadanie tak, by obciążenie modelu miało ten sam ograniczony rozmiar, niezależnie od tego, co przyjdzie. Ta notatka podaje regułę planowania, a nowością w tej rewizji są pomiary stojące za jej dwoma nośnymi twierdzeniami: że koszt jest liniowy, gdy już go ograniczyć (~15,6 s na megapiksel wejścia na maszynie testowej, r² > 0,999), i że kafelkowe wnioskowanie jest wizualnie bezszwowe tylko dlatego, że każdy kafelek niesie 8 px kontekstu, co usuwa 87% energii szwów pozostawianej przez dopełnianie zerami.
Każda liczba w tej notatce została zmierzona na kodzie produkcyjnego potoku: te same modele, ta sama matematyka. Surowe rekordy dla każdego obrazu: e6_tiles.json.
1 · Reguła planowania
Etap celuje w wyjście o dłuższym boku co najwyżej 2560 px, używając modelu superrozdzielczości 4×[1]. Licząc wstecz, model nigdy nie potrzebuje wejścia dłuższego niż 2560 ÷ 4 = 640 px, więc planista wstępnie zmniejsza wszystko, co przychodzi, do tej granicy przed uruchomieniem modelu, ograniczając wejście modelu do około 0,41 megapiksela, niezależnie od tego, czy przesłany plik miał 1 MP, czy 40 MP. Formalnie, dla przesłanego pliku o dłuższym boku L:
Regułę dopełniają trzy zabezpieczenia: wyjście nigdy nie ląduje poniżej pierwotnej rozdzielczości (ulepszanie nigdy nie może kosztować Cię pikseli), wejścia już bliskie celu lub powyżej niego pomijają przebieg w całości (klauzula minimalnego zysku 1,3×, bo poniżej niej obieg przez ponowne próbkowanie i model rozmywa mniej więcej tyle samo, ile wyostrza), a twarze są odnawiane po tym przebiegu, więc wycinki twarzy wchodzą do modelu twarzy w poprawionej rozdzielczości.
2 · Czemu w ogóle ograniczać: koszt jest liniowy, gdy już go takim uczynisz
Twierdzenie, które motywuje cały projekt, jest mierzalne, więc je zmierzyliśmy: produkcyjna ścieżka powiększania (kafelki 192 px, dopełnienie 8 px, ONNX Runtime CPU[3]) uruchomiona na wejściach od 0,04 do 0,39 megapiksela na sprzęcie klasy kontenerowej 2 vCPU:
Z tego samego przemiatania wypada drugi fakt inżynierski: łączny czas działania jest zasadniczo niezależny od rozmiaru kafelka (96 → 384 px, wszystkie lądują w granicach 8% od siebie): praca jest na piksel, a narzut dopełnienia przy 8 px to szum. Rozmiar kafelka dobiera się więc dla pamięci, nie dla szybkości: 192 px utrzymuje szczytowy tensor dość mały dla sterty WASM zapasowego silnika przeglądarkowego.
3 · Podatek od szwów i czemu 8 px kontekstu go spłaca
Kafelkowanie ma tryb awarii, przy którym prace naukowe rzadko się zatrzymują: sploty mają pola recepcyjne, więc kafelek wycięty bez otaczającego kontekstu jest błędny wzdłuż swojego brzegu, a złożona mozaika pokazuje siatkę. Mierzymy to wskaźnikiem szwów: średni gradient luminancji w kolumnach pikseli na granicach kafelków podzielony przez średni gradient gdzie indziej; 1,0 oznacza, że granice są statystycznie niewidoczne:
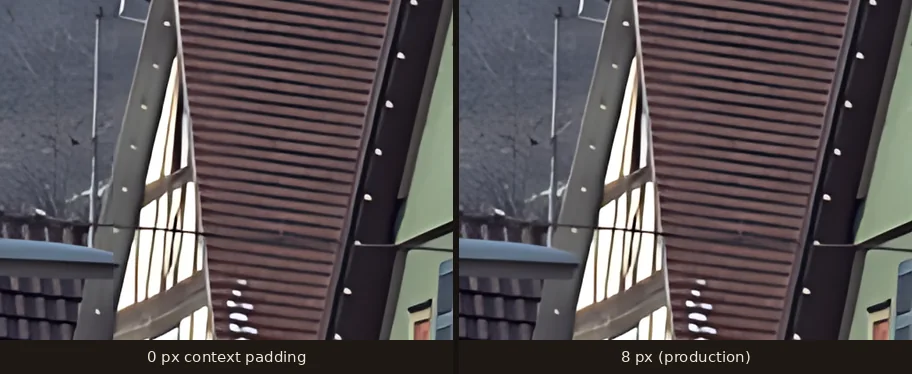
Kształt tej krzywej to argument projektowy w miniaturze: pierwsze dwa piksele kontekstu kupują połowę poprawy, osiem daje malejące zyski, a powyżej ośmiu płacisz mniej więcej kwadratowy narzut dopełnienia za energię szwów, której żaden widz nie znajdzie. (Czy same ulepszone piksele biją klasyczną interpolację, to osobne pytanie ze zmierzoną odpowiedzią; zobacz test na 28 obrazach, gdzie model oddaje 1,07 dB PSNR Lanczos-3 i przywraca 3,1× energii krawędzi[2].)
4 · Zmierzone czasy, od początku do końca
Test: czarno-biały skan 821×1024 odnowiony do 2052×2560, pokolorowany, jedna twarz, na rozgrzanej instancji.
Od początku do końca w produkcji na tym samym zdjęciu: 68 s przy zimnym starcie (ładowanie wag modeli) i 32 s na rozgrzanej. Dla skali: poprzedni potok, który niczego nie powiększał i dotykał tylko twarzy, działał 23–34 s na rozgrzanej; ograniczony przebieg na całym obrazie nie dodaje prawie nic do czasu rzeczywistego, bo jego wejście jest małe z konstrukcji. A gdy to samo zadanie działa w przeglądarce (automatyczny tryb zapasowy), skan 1000×1223 zajął 340,8 s na komputerze z układem Apple i WebGPU (ten sam ograniczony plan, mniej więcej 10× czasu rzeczywistego). To ograniczenie sprawia, że nawet ten najgorszy przypadek pozostaje użyteczny, zamiast być nieograniczonym.
5 · Co odrzucono
Superrozdzielczość opartą na dyfuzji (o wiele za wolna dla interaktywnego narzędzia na naszym stosie), większe modele odnawiania pojedynczych twarzy jako domyślne (czas na twarz puchnie na zdjęciach grupowych) oraz wysyłanie zdjęć do zewnętrznych API wnioskowania na GPU: zdjęcia opuściłyby naszą infrastrukturę, co wyklucza obietnica prywatności. Ograniczony plan trzyma zyski jakości tam, gdzie widz naprawdę je dostrzega, w obrazie wielkości ekranu, zamiast płacić kwadratowo za piksele, których nikt nie zobaczy.
6 · Ograniczenia
Cel 2560 px to decyzja produktowa, nie optimum: wydruki korzystają z większej rozdzielczości, a przyszły płatny plan mógłby podnieść granicę. Powyższe czasy to przypadek typowy: zdjęcia gęste od twarzy spędzają proporcjonalnie więcej w etapie twarzy, którego ograniczenie ulepszania nie obejmuje. A wskaźnik szwów to instrument statystyczny: poświadcza, że granice są średnio ciche, a nie że żadna złośliwa faktura nigdy jednej nie ujawni.
Źródła
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai