Seberapa besar AI harus memperbesar? Desain yang dibatasi
Model super-resolusi bersifat kuadratik: gandakan sisi input dan kamu melipatempatkan pekerjaannya, dan waktu tunggunya. Jalankan secara naif atas apa pun yang orang unggah dan pindaian 40 megapiksel memakan waktu bermenit-menit sementara jepretan ponsel hanya beberapa detik. Tahap peningkatan kami justru merencanakan setiap pekerjaan supaya beban kerja model selalu berukuran terbatas yang sama, apa pun yang tiba. Catatan ini memberikan aturan perencanaannya, dan, baru dalam revisi ini, pengukuran di balik dua klaim penopangnya: bahwa biaya bersifat linear begitu dibatasi (~15,6 s per megapiksel input pada mesin bench, r² > 0,999), dan bahwa inferensi berubin tampak mulus tanpa sambungan hanya karena setiap ubin membawa 8 px konteks, yang menghapus 87% energi sambungan yang ditinggalkan zero-padding.
Setiap angka dalam catatan ini diukur pada kode pipeline produksi: model yang sama, matematika yang sama. Rekaman mentah per gambar: e6_tiles.json.
1 · Aturan perencanaan
Tahap ini menargetkan output paling banyak 2560 px pada sisi panjang, memakai model super-resolusi 4×[1]. Dihitung mundur, model tidak pernah membutuhkan input yang lebih panjang dari 2560 ÷ 4 = 640 px, sehingga perencana memperkecil apa pun yang tiba ke batas itu sebelum model berjalan, membatasi input model di sekitar 0,41 megapiksel entah unggahannya 1 MP atau 40 MP. Secara formal, untuk unggahan dengan sisi panjang L:
Tiga pagar pengaman melengkapi aturannya: output tidak pernah jatuh di bawah resolusi asli (peningkatan tidak boleh mengorbankan pikselmu), input yang sudah dekat atau di atas target melewati tahap ini sepenuhnya (klausul keuntungan minimum 1,3×, karena di bawah itu perjalanan bolak-balik resample-dan-model mengaburkan kira-kira sebanyak ia mempertajam), dan wajah direstorasi setelah tahap ini, sehingga potongan wajah memasuki model wajah pada resolusi yang sudah membaik.
2 · Mengapa perlu batas: biaya bersifat linear, setelah kamu membuatnya begitu
Klaim yang memotivasi seluruh desain ini bisa diukur, jadi kami mengukurnya: jalur upscale produksi (ubin 192 px, padding 8 px, ONNX Runtime CPU[3]) dijalankan atas input dari 0,04 sampai 0,39 megapiksel pada perangkat keras kelas kontainer 2-vCPU:
Fakta teknik kedua muncul dari sapuan yang sama: total waktu jalan pada dasarnya tidak bergantung pada ukuran ubin (96 → 384 px semuanya berada dalam rentang 8% satu sama lain): pekerjaannya per piksel, dan overhead padding pada 8 px hanyalah derau. Ukuran ubin karena itu dipilih demi memori, bukan kecepatan: 192 px menjaga tensor puncak cukup kecil untuk heap WASM mesin fallback browser.
3 · Pajak sambungan, dan mengapa 8 px konteks melunasinya
Pengubinan punya mode kegagalan yang jarang dibahas makalah: konvolusi punya receptive field, sehingga ubin yang dipotong tanpa konteks di sekelilingnya salah di sepanjang tepinya, dan mosaik yang dirakit kembali memperlihatkan sebuah grid. Kami mengukurnya dengan indeks sambungan: rata-rata gradien luma melintasi kolom piksel perbatasan ubin dibagi rata-rata gradien di tempat lain; 1,0 berarti perbatasan tidak terlihat secara statistik:
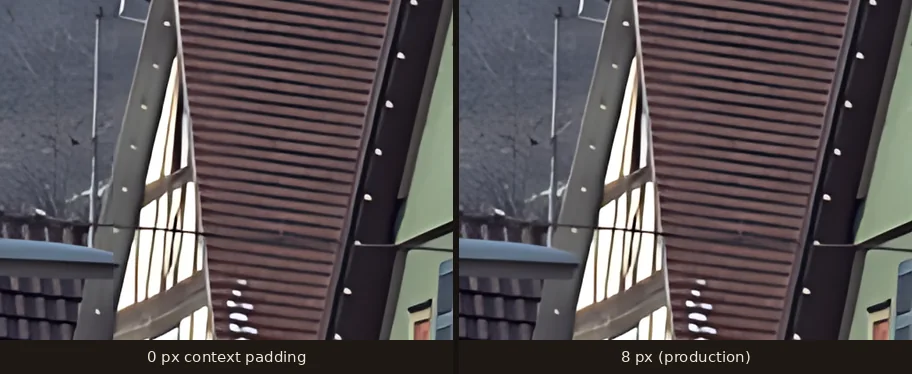
Bentuk kurva itu adalah argumen desainnya dalam miniatur: dua piksel konteks pertama membeli separuh perbaikan, delapan membeli hasil yang semakin menurun, dan lewat delapan kamu membayar overhead padding yang nyaris kuadratik demi energi sambungan yang tidak bisa ditemukan penonton mana pun. (Apakah piksel yang ditingkatkan itu sendiri mengalahkan interpolasi klasik adalah pertanyaan terpisah dengan jawaban terukur; lihat benchmark 28 gambar, di mana model menyerahkan 1,07 dB PSNR kepada Lanczos-3 dan memulihkan 3,1× energi tepi[2].)
4 · Waktu terukur, ujung ke ujung
Benchmark: pindaian hitam putih 821×1024 direstorasi ke 2052×2560, diwarnai, satu wajah, pada instans yang sudah hangat.
Ujung ke ujung di produksi pada foto yang sama: 68 s pada cold start (bobot model dimuat) dan 32 s saat hangat. Sebagai perbandingan: pipeline sebelumnya, yang tidak meng-upscale apa pun dan hanya menyentuh wajah, berjalan 23–34 s saat hangat; tahap seluruh gambar yang terbatas nyaris tidak menambah wall clock, karena inputnya kecil secara konstruksi. Dan ketika pekerjaan yang sama berjalan di dalam browser (fallback otomatis), pindaian 1000×1223 memakan 340,8 s pada desktop Apple silicon dengan WebGPU (rencana terbatas yang sama, kira-kira 10× wall clock). Batas itulah yang membuat bahkan kasus terburuk itu tetap bisa dipakai, bukan tak terbatas.
5 · Yang ditolak
Super-resolusi berbasis difusi (terlalu lambat untuk alat interaktif di stack kami), model restorasi per wajah yang lebih besar sebagai default (waktu per wajah membengkak pada foto kelompok), dan mengirim foto ke API inferensi GPU eksternal: foto akan meninggalkan infrastruktur kami, yang dilarang oleh janji privasi. Rencana terbatas menjaga keuntungan kualitas di tempat penonton benar-benar merasakannya, gambar seukuran layar, alih-alih membayar secara kuadratik untuk piksel yang tidak bisa dilihat siapa pun.
6 · Keterbatasan
Target 2560 px adalah keputusan produk, bukan optimum: cetakan diuntungkan oleh resolusi yang lebih tinggi, dan tingkatan berbayar di masa depan bisa menaikkan batasnya. Waktu di atas adalah kasus umum: foto yang padat wajah menghabiskan proporsi lebih besar di tahap wajah, yang tidak dicakup batas peningkatan. Dan indeks sambungan adalah instrumen statistik: ia menyatakan perbatasan tenang secara rata-rata, bukan bahwa tidak ada tekstur adversarial yang bisa mengungkapkan salah satunya.
Referensi
- Wang, X., Xie, L., Dong, C., & Shan, Y. (2021). Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data. ICCV Workshops. arXiv:2107.10833. arxiv.org
- Kodak Lossless True Color Image Suite: 24 uncompressed 768×512 PhotoCD reference images, the classic image-quality test set. r0k.us
- ONNX Runtime: the inference engine both our server (CPU) and in-browser (WebGPU/WASM) engines run on. onnxruntime.ai